El lunes, necesita cargar una hoja de cálculo en un DataFrame. Para el miércoles, un cliente ha enviado una plantilla de libro que debe actualizarse sin perder sus gráficos. Para el viernes, el equipo de finanzas necesita el informe exportado a PDF, mientras que el libro original debe permanecer protegido con contraseña. Elegir la mejor biblioteca de Excel para Python significa ajustar la biblioteca a estos distintos trabajos. Una mala elección puede no hacerse evidente hasta más tarde: los gráficos desaparecen después de guardar, las fórmulas no tienen resultados calculados utilizables o la biblioteca seleccionada no puede leer un libro binario .xlsb.
Para ayudar a los desarrolladores a tomar la decisión correcta, probamos cuatro bibliotecas usando fixtures de prueba compartidos y un conjunto de datos común de 50.000 filas: pandas 3.1.0, openpyxl 3.1.5, XlsxWriter 3.3.1 y Spire.XLS for Python 16.8.2 (comercial). Evaluamos la compatibilidad de formatos de archivo, la edición y preservación de libros, el manejo de fórmulas, la conversión a PDF y HTML, el cifrado de libros, el rendimiento, el uso de memoria, los requisitos de instalación y las licencias. Los resultados muestran qué hace bien cada biblioteca, dónde están sus limitaciones y qué opción puede encajar mejor en distintos proyectos. Esta comparación se centra en tres bibliotecas de código abierto y un SDK comercial; otras soluciones comerciales quedan fuera de su alcance.
¿Qué biblioteca de Excel para Python debería elegir?
Cada una de las tres bibliotecas de código abierto hace muy bien una tarea, y Spire.XLS cubre proyectos en los que esas tareas tienen que ejecutarse juntas. La tabla siguiente ofrece la versión breve. Las secciones posteriores explican el razonamiento y muestran los datos de prueba.
| Biblioteca | Ideal para | Consideración a largo plazo |
|---|---|---|
| pandas | Análisis de datos | Requiere otras herramientas para operaciones a nivel de libro |
| openpyxl | Editar plantillas XLSX | Sin motor integrado de cálculo de fórmulas |
| XlsxWriter | Crear informes con formato | No puede volver a abrir libros existentes |
| Spire.XLS | Procesamiento de Excel en varios pasos | Licencia comercial con soporte del proveedor y opciones de actualización |
Si solo necesita leer datos en un DataFrame, pandas con el motor calamine es suficiente, y puede dejar de leer aquí. Si su proyecto está creciendo hacia la automatización, consulte nuestra guía para automatizar la escritura en Excel con Python.
Qué hacen mejor las bibliotecas de Excel de código abierto para Python
pandas, openpyxl y XlsxWriter son complementarias en lugar de intercambiables. Cada una destaca en una única tarea, y por eso muchos proyectos terminan usando dos o tres de ellas en paralelo.
pandas: leer y analizar datos tabulares
pandas convierte una hoja de cálculo en un DataFrame, que es la forma adecuada para el análisis. Con el motor calamine lee archivos .xlsx, .xlsb, .ods y .xls, y fue el lector más rápido en nuestra prueba: 294 ms para 50.000 filas × 6 columnas (mediana de cinco ejecuciones). El formato es posible mediante Styler con jinja2, que rellena y pone en negrita las celdas según lo esperado. En pandas 3.1, nuestros intentos de formato numérico no surtieron efecto, y las celdas permanecieron en General.
El límite es conceptual. Un DataFrame no es un libro. Escribir uno de vuelta con to_excel reconstruye el archivo, por lo que los gráficos, las imágenes y las tablas dinámicas no se conservan. Las fórmulas se pueden escribir, pero no se calculan. Para más información sobre lectura, consulte leer archivos de Excel en Python y la documentación de E/S de Excel de pandas.
openpyxl: editar archivos .xlsx y .xlsm existentes
openpyxl carga un libro, permite modificarlo y lo guarda. En nuestro libro de prueba, un recorrido de ida y vuelta conservó gráficos, imágenes, formato condicional, validación de datos, celdas combinadas, paneles inmovilizados, filtros y partes de tablas dinámicas, y Excel 16.0 abrió el resultado sin errores. Es un resultado para nuestros fixtures, no una promesa para todas las formas DrawingML o proyectos VBA.
Sus límites son específicos. Admite cuatro formatos OOXML (.xlsx, .xlsm, .xltx, .xltm). No tiene motor de cálculo, por lo que las fórmulas permanecen sin calcular. No puede abrir archivos protegidos con contraseña sin una herramienta externa como msoffcrypto. Las tablas dinámicas se pueden preservar, pero crear una implica ensamblar la caché y la definición a mano mediante la llamada de bajo nivel add_pivot. Su modo write_only utilizó la menor memoria de todos los escritores que probamos: 79,4 MB. Documentación: openpyxl.
XlsxWriter: generar nuevos informes
XlsxWriter escribe nuevos archivos .xlsx y los escribe bien. Admite formatos, gráficos, imágenes, formato condicional, validación de datos y fórmulas con valores en caché. Fue el escritor más rápido en nuestra prueba con 1,74 s para 50.000 filas, por delante de todos los demás métodos de esta prueba, incluidos pandas y openpyxl.
No puede leer ni modificar un archivo existente. No permite crear tablas dinámicas, ni cifrado, ni salida .xlsb o .ods. Documentación: XlsxWriter.
Cuando las bibliotecas básicas de Excel no son suficientes
Las bibliotecas de código abierto dejan de ser suficientes cuando una tarea cruza la frontera entre sus especialidades. Cinco situaciones aparecen repetidamente.
- Varios formatos de archivo en una misma canalización. pandas puede leer xls, xlsb y ods, pero devuelve un DataFrame y no puede guardar el libro editado en el mismo formato. openpyxl y XlsxWriter no manejan esos formatos en absoluto.
- Fórmulas que deben recalcularse después de una edición. openpyxl conserva las fórmulas pero no puede evaluarlas. pandas escribe fórmulas sin resultados, y el valor en caché depende del motor subyacente: un valor vacío con openpyxl, un 0 de marcador de posición con xlsxwriter. Excel recalcula al abrir, pero cualquier otro lector no ve nada útil.
- Tablas dinámicas y otros objetos complejos. openpyxl puede conservar una tabla dinámica existente, pero no ofrece una forma de alto nivel para crear una. XlsxWriter y pandas no ofrecen ninguna.
- Salida a PDF, HTML o imagen. Convertir una hoja de cálculo en un PDF paginado requiere una biblioteca adicional, y usted asume el diseño de página, el escalado y la paginación.
- Protección con contraseña. Ninguna de las tres bibliotecas de código abierto puede escribir un libro que requiera contraseña para abrirse.
Nada de esto hace que las herramientas de código abierto sean una mala elección. El proyecto simplemente creció más allá de lo que cubre una herramienta de propósito único, y el coste se traslada al código de pegamento: conversiones de formato, traspasos de archivos entre bibliotecas y actualizaciones de dependencias por separado. Cada herramienta adicional añade su propia dependencia, sus propias excepciones y su propia forma de pasar archivos.
Qué puede hacer con Spire.XLS for Python
Spire.XLS for Python es una biblioteca comercial que maneja la lectura, edición, cálculo, conversión y protección de archivos de Excel mediante un único modelo de objetos de libro. No necesita Microsoft Office instalado. Esto es lo que cubre en la práctica, con los límites indicados.
Leer y escribir varios formatos de Excel
LoadFromFile abre archivos .xls, .xlsx, .xlsm, .xlsb y .ods, y SaveToFile escribe en xlsx, xls, xlsb, xlsm, ods, csv, pdf, html y png. CSV se carga con un argumento de delimitador, como LoadFromFile("data.csv", ","). Un caso típico es un sistema upstream que exporta .xlsb mientras el consumidor downstream espera .xlsx o PDF.
from spire.xls import *

wb = Workbook()
wb.LoadFromFile("upstream.xlsb")
wb.SaveToFile("converted.xlsx", ExcelVersion.Version2016)
Una nota de compatibilidad: en nuestra prueba, Excel 16.0 abrió los archivos .xlsb y .ods que produjo Spire.XLS, mientras que los lectores de pandas (pyxlsb y calamine) no abrieron esos archivos concretos. Haga pruebas de regresión de los formatos heredados con los lectores que usen sus sistemas downstream.
Editar libros existentes y crear tablas dinámicas
Cargue un libro, modifíquelo y guárdelo. En nuestro libro de prueba, gráficos, imágenes, formato condicional, validación de datos, celdas combinadas, paneles inmovilizados, filtros y tablas dinámicas sobrevivieron al recorrido de ida y vuelta, sin errores cuando Excel abrió el archivo. Aun así, las formas DrawingML complejas deben comprobarse con sus archivos reales.
Crear una tabla dinámica requiere dos llamadas:
sheet = wb.Worksheets[0]
cache = wb.PivotCaches.Add(sheet.Range["A1:F20"])
pivot = sheet.PivotTables.Add("SalesPivot", sheet.Range["H3"], cache)
El rango de origen debe comenzar con una fila de encabezado, y estas llamadas crean la estructura de la tabla dinámica; los campos de fila y de valor se configuran después. Consulte crear u operar tablas dinámicas en Excel para la configuración de campos. En nuestra prueba, Excel abrió el archivo resultante y contó una tabla dinámica.
Recalcular fórmulas y valores en caché
Aqui importan tres términos: la fórmula, su resultado en caché y el recálculo. Un archivo con una fórmula pero sin resultado en caché parece vacío para cualquier lector que no calcule. Spire.XLS incluye un motor de cálculo, por lo que llamar a CalculateAllValue() calcula los resultados antes de guardar, y otras herramientas que lean el archivo pueden verlos.
wb.LoadFromFile("model.xlsx")
wb.CalculateAllValue()
wb.SaveToFile("model_calculated.xlsx", ExcelVersion.Version2016)
openpyxl y pandas no pueden hacer este paso. XlsxWriter puede almacenar un valor en caché, pero solo si usted proporciona el número. Para la sintaxis de fórmulas y ejemplos a nivel de celda, consulte agregar o leer fórmulas en Excel.
Convertir Excel a PDF, HTML e imágenes
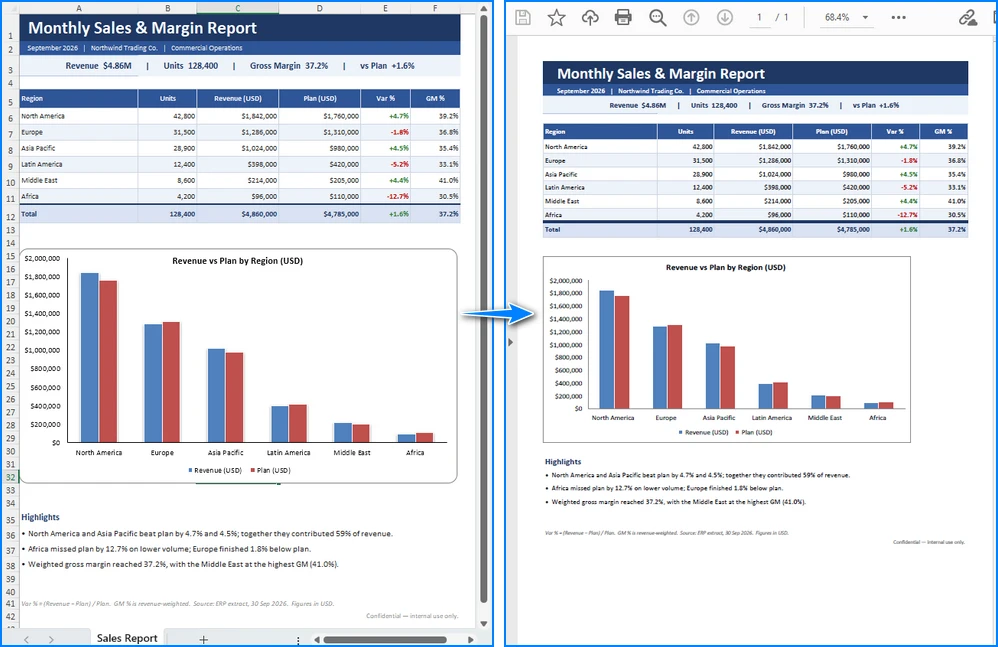
Para PDF, configure primero el diseño de página. Con orientación horizontal y escalado para ajustar a la página, nuestro gráfico de prueba cabía en la página en lugar de quedar cortado.
sheet = wb.Worksheets[0]
sheet.PageSetup.Orientation = PageOrientationType.Landscape
sheet.PageSetup.FitToPagesWide = 1
sheet.PageSetup.FitToPagesTall = 1
wb.SaveToFile("report.pdf", FileFormat.PDF)
La salida HTML predeterminada es un frameset con una carpeta de recursos. Establecer HTMLOptions.ImageEmbedded = True produce un único archivo autocontenido (61 KB en nuestra prueba, con dos imágenes incrustadas como base64). La exportación de imágenes está disponible mediante ToImage. Consulte nuestra guía para convertir Excel a PDF en Python para los detalles de diseño. Los límites de la edición de prueba se explican en la sección de licencias a continuación.
Proteger libros de Excel con contraseñas
Protect("password") establece una contraseña de apertura. En nuestra prueba, el archivo guardado se convirtió en un contenedor cifrado que no se podía abrir sin la contraseña, y Spire.XLS podía volver a abrirlo cuando se le proporcionaba la contraseña. Esto sirve para la entrega de informes y casos de cumplimiento. Las protecciones a nivel de permisos, como bloquear hojas concretas, se configuran por separado; siga la documentación oficial para ello. Tenga en cuenta que, en la sobrecarga de dos cadenas, el segundo argumento de SaveToFile es un delimitador CSV, no una contraseña.
Crear un flujo de trabajo de procesamiento de Excel de varios pasos
Un servicio de informes mensuales muestra la diferencia con claridad. La tarea: leer un archivo .xlsb upstream, actualizar sus cifras de entrada, recalcular las fórmulas, producir un PDF, cifrar la copia de Excel y guardarla como .xlsx.
| pandas + openpyxl + otras 2 herramientas | XlsxWriter | Spire.XLS | |
|---|---|---|---|
| Leer .xlsb | ✅ (solo datos) | ❌ | ✅ |
| Conservar objetos del libro | No (en la ruta xlsb) | ❌ | ✅ |
| Recalcular fórmulas | ❌ | ❌ | ✅ |
| Exportar a PDF | Requiere biblioteca adicional | Requiere biblioteca adicional | ✅ |
| Cifrar | Requiere biblioteca adicional | ❌ | ✅ |
| Dependencias para la tarea | 4 o más | 1 (solo escritura) | 1 |
La ruta de código abierto funciona, pero reparte la tarea entre al menos cuatro herramientas: una para leer el formato binario, una para editar, una para renderizar un PDF y una para cifrar, además de un convertidor si necesita conservar los objetos del libro. Cada traspaso es un archivo escrito por una biblioteca y releído por otra. Con Spire.XLS los mismos pasos se ejecutan sobre un único objeto de libro:
from spire.xls import *

wb = Workbook()
wb.LoadFromFile("monthly_input.xlsb")        # 1. read legacy format

sheet = wb.Worksheets[0]
sheet.Range["B2"].NumberValue = 125000        # 2. update an input value

wb.CalculateAllValue()                        # 3. recalculate formulas

sheet.PageSetup.Orientation = PageOrientationType.Landscape
sheet.PageSetup.FitToPagesWide = 1
sheet.PageSetup.FitToPagesTall = 1
wb.SaveToFile("monthly_report.pdf", FileFormat.PDF)   # 4. PDF

wb.Protect("s3cret")                          # 5. encrypt
wb.SaveToFile("monthly_report.xlsx", ExcelVersion.Version2016)
wb.Dispose()
Coste total de desarrollo y mantenimiento
No medimos el tiempo ahorrado, y este artículo no afirma una cifra. La diferencia que podemos describir es la complejidad: cuántos pasos, dependencias e interfaces implica la tarea.
| Dimensión | Combinación de código abierto | Spire.XLS |
|---|---|---|
| Integración | Traspasos de datos y conversiones de formato entre herramientas | Una única API de libro |
| Mantenimiento | Varios componentes que actualizar y mantener compatibles | Una única línea de versión de producto |
| Resolución de problemas | Problemas repartidos entre proyectos separados | Un único punto de entrada, más soporte del proveedor |
| Soporte | Comunidad y rastreadores de incidencias | Canales oficiales de soporte, según la licencia |
El resumen es una biblioteca de procesamiento de Excel, no una dependencia. Su proyecto seguirá usando otros paquetes. Lo que cambia es que los pasos de Excel comparten un único modelo de objetos.
¿Quiere probar el flujo de trabajo usted mismo? Empiece con Free Spire.XLS for Python para lectura y escritura de xlsx e informes pequeños, o use la versión de prueba de Spire.XLS for Python para evaluar la API completa.
Rendimiento, implementación, soporte y mantenimiento
Benchmarks de rendimiento
Ejecutamos cada operación en su propio proceso con una ejecución de calentamiento descartada y luego cinco ejecuciones medidas, informando la mediana. El conjunto de datos era de 50.000 filas × 6 columnas en una máquina Windows x64 (8 núcleos lógicos, 7,8 GB de RAM, Python 3.12).
| Tarea | Método | Mediana | Memoria máxima |
|---|---|---|---|
| Lectura | pandas (calamine) | 294 ms | 108,2 MB |
| Lectura | Spire.XLS | 1.456 ms | 312,2 MB |
| Lectura | openpyxl read_only
|
1.704 ms | 43,9 MB |
| Lectura | pandas (motor openpyxl) | 2.177 ms | 91,9 MB |
| Escritura | XlsxWriter | 1.744 ms | 118,8 MB |
| Escritura | pandas → xlsxwriter | 3.477 ms | 118,2 MB |
| Escritura | openpyxl write_only
|
3.803 ms | 79,4 MB |
| Escritura | Spire.XLS InsertArray (por columna) |
3.987 ms | 325,2 MB |
| Escritura | pandas → openpyxl | 5.205 ms | 173,6 MB |
XlsxWriter es el escritor más rápido, pandas con calamine es el lector más rápido y el modo de solo escritura de openpyxl es el que menos memoria usa. Esas herramientas especializadas siguen siendo la mejor opción para el rendimiento bruto; Spire.XLS es la opción cuando un flujo de trabajo necesita varias tareas de Excel. Sus cifras de lectura, escritura y memoria están en la tabla anterior. La razón para elegirlo es la cobertura, no el rendimiento. Estas cifras provienen de una máquina y una carga de trabajo, así que tómelas como referencia y no como clasificación.
Implementación y compatibilidad
Ninguna de las cuatro bibliotecas necesita Microsoft Office. Excel estaba instalado en nuestra máquina de prueba solo para abrir los archivos generados y validarlos; ninguna conversión lanzó un proceso de Excel. Las cuatro se ejecutaron en Python 3.14.6.
| pandas | openpyxl | XlsxWriter | Spire.XLS | |
|---|---|---|---|---|
| Tamaño de instalación | 45 MB (+ numpy 25 MB) | 1,8 MB | 1,6 MB | 70,6 MB |
| Importación en frío | 788 ms | 524 ms | 230 ms | 1.027 ms |
Spire.XLS es una instalación más grande, de 70,6 MB, aunque el stack de pandas es comparable una vez incluido numpy. Para imágenes de contenedor y arranques en frío, sopeselo frente a los paquetes que puede reemplazar en un flujo de trabajo de varios pasos.
Actualizaciones continuas y mantenimiento del producto
El equipo de producto de Spire.XLS confirma una cadencia de lanzamientos mensual para la línea de producto. Para el paquete de Python, el registro de PyPI muestra lanzamientos regulares en 2026: 16.2.0 (5 de febrero), 16.4.0 (8 de abril), 16.5.0 (7 de mayo), 16.6.0 (18 de junio), 16.7.1 (17 de julio) y 16.8.2 (25 de agosto). La versión 16.8.2 añadió compatibilidad con la función de fórmula TEXTSPLIT y corrigió problemas relacionados con OFD, según las notas de la versión oficiales. El paquete de Python sigue la misma línea de lanzamiento; consulte las notas de la versión que planea implementar.
Soporte técnico y recursos para desarrolladores
Spire.XLS for Python incluye documentación de API, ejemplos de código, tutoriales, un foro para desarrolladores y soporte por correo electrónico. Las licencias comerciales incluyen un año de actualizaciones gratuitas y soporte técnico, según los términos de la licencia. Los objetivos de respuesta dependen del tipo de licencia. Según la página de soporte de pago de este producto, las licencias Developer OEM, Site y Small Business indican 48 horas laborables, Site OEM indica 24 horas laborables, y los niveles Gold y Platinum ofrecen respuesta en 24 horas con soporte experto. Confirme los términos actuales de su licencia en la página de soporte antes de comprar.
Para implementaciones de producción y empresariales, el soporte forma parte de los criterios de selección: una ruta de escalado definida, objetivos de respuesta documentados por nivel de licencia y gestión prioritaria en los niveles superiores. Las bibliotecas de código abierto dependen de foros comunitarios y rastreadores de incidencias para la misma clase de problemas.
Más allá de la cobertura de API, una biblioteca comercial también es una relación de mantenimiento. Spire.XLS for Python se mantiene activamente, con lanzamientos regulares que añaden funcionalidad y abordan los problemas reportados. Los usuarios con licencia reciben actualizaciones y soporte técnico según los términos de su licencia, y los niveles de soporte superiores ofrecen objetivos de respuesta más rápidos y gestión prioritaria.
Spire.XLS gratis, de prueba y comercial
Spire.XLS se ofrece en tres formas con límites diferentes. Elija según lo que necesite verificar.
| Edición | Versión | Límites | Ideal para |
|---|---|---|---|
| Free Spire.XLS | 14.12.4 | .xlsx ilimitado; .xls limitado a 5 hojas × 200 filas; PDF limitado a 3 páginas; sin marca de agua | Verificar lectura/escritura de xlsx e informes pequeños |
| Spire.XLS de prueba | 16.8.2 | Hoja de advertencia de evaluación y marca de agua en PDF; conversiones que no son de imagen limitadas a las primeras 10 páginas | Evaluar la API y conversiones de 10 páginas o menos |
| Comercial | 16.8.2 | Ninguno de los límites anteriores (consulte el contrato de licencia) | Producción |
En las pruebas de las ediciones de prueba y Free, la lectura y escritura de xlsx no estuvo limitada por filas ni hojas. Según las notas de limitaciones del proveedor, la exportación de imágenes no se ve afectada por el límite de 10 páginas. Un detalle práctico: después de que la edición Free guarda un archivo .xls, el libro en memoria se trunca, así que vuelva a cargar el origen si necesita guardar ambos formatos.
¿Qué ofrece una licencia comercial?
Una licencia comercial añade una relación de actualización y soporte sobre la API. Incluye:
- un año de actualizaciones gratuitas
- un año de soporte técnico gratuito
- tiempos de respuesta que dependen del tipo de licencia
- respuesta en 24 horas y soporte experto en los niveles Gold y Platinum
- consulta técnica previa a la compra por correo electrónico y en el foro
¿Qué biblioteca de Excel para Python encaja con su proyecto?
Ajuste la biblioteca al número de tareas que su canalización tiene que realizar.
- Solo leer datos: use pandas con calamine.
- Solo generar nuevos informes: use XlsxWriter.
- Solo editar plantillas existentes: use openpyxl.
- Dos o más necesidades avanzadas (varios formatos, recálculo, conversión, cifrado, tablas dinámicas): considere Spire.XLS, que además aporta una cadencia de lanzamientos mantenida y un canal de soporte del proveedor.
La regla que usamos: cuente las tareas, no las funciones. Una tarea requiere una herramienta especializada. Dos tareas son el punto para empezar a considerar una biblioteca integrada, y tres o más en una misma canalización son donde claramente se amortiza. Si está en el límite, ejecute sus archivos reales con ambos enfoques. Recuerde que los resultados de fidelidad son específicos de los archivos probados, y los objetos complejos siempre deben verificarse con sus propios libros.
¿Listo para probarlo con sus propios archivos? Descargue Free Spire.XLS for Python o la edición de prueba, y lea la documentación de Spire.XLS for Python para ver cómo se adapta el flujo de trabajo anterior a su proyecto.
Preguntas frecuentes
¿Qué biblioteca de Python puede leer y escribir Excel sin Microsoft Office?
Las cuatro bibliotecas de este artículo funcionan sin Office. pandas (mediante calamine u openpyxl) lee, XlsxWriter escribe, openpyxl lee y escribe .xlsx/.xlsm, y Spire.XLS lee y escribe muchos formatos. En nuestra prueba, Excel se usó solo para comprobar los archivos de salida.
pandas vs openpyxl: ¿cuál debería usar?
Use pandas para cargar datos tabulares para análisis, y openpyxl para modificar un libro conservando su estructura. pandas reescribe el archivo al guardar, por lo que objetos como gráficos y tablas dinámicas no se conservan. openpyxl los conserva en los escenarios que probamos.
¿Puede openpyxl editar un libro sin perder gráficos ni tablas dinámicas?
En nuestro libro de prueba, sí: se conservaron gráficos, imágenes, formato condicional, validación de datos y partes de tablas dinámicas, y Excel abrió el archivo con normalidad. Las formas más allá de nuestros fixtures y VBA (que necesita keep_vba=True) no se cubrieron, así que pruebe sus propios archivos.
¿Cómo convierto Excel a PDF en Python sin Excel instalado?
Use una biblioteca que renderice los libros por sí misma. Con Spire.XLS, configure la orientación horizontal y FitToPagesWide/FitToPagesTall, luego guarde con FileFormat.PDF. La edición de prueba limita la salida PDF a 10 páginas y añade una marca de agua.
¿Estas bibliotecas son gratuitas para uso comercial?
pandas, openpyxl y XlsxWriter son de código abierto. Spire.XLS es un producto comercial con una edición Free (xlsx sin restricciones; .xls 5 hojas × 200 filas; PDF 3 páginas) y una edición de prueba. Revise cada licencia para su caso de uso.
¿Qué biblioteca admite .xls, .xlsb y .ods?
pandas con el motor calamine los lee los tres. openpyxl no los admite, y XlsxWriter solo escribe .xlsx. Spire.XLS lee y escribe xls, xlsb y ods, aunque debe probar su salida xlsb y ods con sus propios lectores downstream.
Cómo lo probamos
Probamos el 2 de noviembre de 2026 con pandas 3.1.0, openpyxl 3.1.5, XlsxWriter 3.3.1 y Spire.XLS for Python 16.8.2 (prueba), además de Free Spire.XLS 14.12.4 para los límites de edición. El hardware era Windows x64 con 8 núcleos lógicos y 7,8 GB de RAM. El entorno de ejecución era Python 3.12.13, con 3.14.6 usado para comprobar la compatibilidad.
Los fixtures de funcionalidad eran un libro de tres hojas con 20 filas, fórmulas, gráficos, imágenes, formato condicional, validación de datos, celdas combinadas, paneles inmovilizados y filtros, además de un fixture separado de tabla dinámica. El rendimiento usó 50.000 filas × 6 columnas (1,18 MB), una ejecución de calentamiento descartada, cinco ejecuciones medidas y la mediana, con cada operación en un proceso separado. La escritura masiva de Spire está orientada a columnas, así que su benchmark usó seis llamadas a InsertArray en lugar de una inserción bidimensional. Microsoft Excel 16.0 se usó solo para abrir los archivos generados y contar gráficos y tablas dinámicas.
No cubierto: VBA, segmentaciones, Power Query, archivos de un millón de filas, concurrencia y ejecuciones en Linux o macOS. El benchmark es de una sola máquina y una sola carga de trabajo, con cierta carga de CPU en segundo plano del 12–22 %. Los detalles de mantenimiento y soporte provienen de páginas públicas oficiales y registros de PyPI, no de nuestras pruebas.