Dati dei moduli PDF round-trip: esportazione e importazione con JavaScript
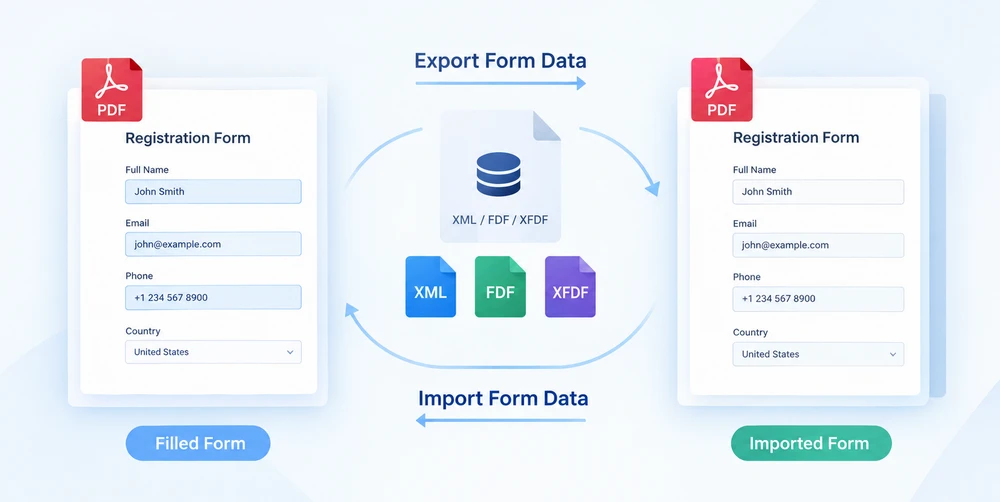
Quando un modulo PDF viene compilato, i valori inseriti si fondono con il layout visivo in un artefatto sigillato. Trasferire quelle voci su un modello diverso significa ridigitare ogni campo a mano. La via d'uscita è trattare i dati del modulo come una risorsa portatile: estrarre i valori dei campi in un file di dati autonomo, quindi reinserirlo in una copia vuota del modulo per riprodurre tutte le voci in un'unica passata automatica. Questo ciclo esporta-poi-importa è ciò che Spire.PDF for JavaScript offre tramite PdfFormWidget.ExportData e PdfFormWidget.ImportData.
Entrambi i metodi accettano tre formati di file: XML, FDF e XFDF. Passare dall'uno all'altro non è altro che cambiare un valore dell'enumerazione DataFormat: la convenzione di chiamata resta identica; cambia solo la struttura su disco del file di output. Poiché Spire.PDF for JavaScript viene eseguito interamente nel browser sopra WebAssembly, l'intero ciclo viene eseguito localmente attraverso un file system virtuale (VFS), senza alcun server backend coinvolto e senza che alcun documento lasci mai il client.
Questo articolo illustra il flusso di dati completo:
- Esportare i dati del modulo — estrarre i valori dei campi da un modulo compilato
- Importare i dati del modulo — reinserire quei valori in un modulo vuoto
Per l'installazione e la configurazione del progetto, consulta Integrare Spire.PDF for JavaScript in un progetto React. Gli esempi seguenti presuppongono che Spire.PDF sia installato e che il modulo WebAssembly sia inizializzato.
Tre formati di dati del modulo in breve
Prima di addentrarci nel codice, è utile comprendere i tre formati con cui lavorano ExportData e ImportData. Tutti e tre trasportano lo stesso contenuto — un insieme di coppie nome-campo/valore — ma lo confezionano in modi diversi. Scegliere quello giusto fin dall'inizio evita attriti successivi, quando il file di dati deve essere condiviso, ispezionato o inserito in un altro strumento.
| Formato | Valore enum | Struttura del file | Leggibile dall'uomo | Ideale per |
|---|---|---|---|---|
| XML | DataFormat.Xml |
XML dei dati di modulo Adobe; il nome del campo diventa il nome dell'elemento, il valore è il contenuto dell'elemento | Sì | Ispezione rapida, debug, strumenti semplici |
| FDF | DataFormat.Fdf |
Forms Data Format; una struttura testuale che inizia con %FDF-, dove /T contiene il nome del campo e /V il valore |
No | Trasferimento compatto tra programmi |
| XFDF | DataFormat.XFdf |
XFDF, XML standard; un <field name="…"> per campo, con il valore all'interno di <value> |
Sì | Controllo di versione, scambio tra sistemi |
Tutti e tre sono senza perdita di dati rispetto ai valori dei campi: nulla viene eliminato o trasformato durante l'esportazione o l'importazione. La scelta tra loro riguarda esclusivamente l'idoneità al flusso di lavoro, aspetto a cui torniamo nella guida alla scelta del formato qui sotto.
Esportare i dati di un modulo PDF
La prima metà del ciclo è l'estrazione. PdfFormWidget.ExportData preleva ogni valore dei campi del modulo e lo scrive in un unico file di dati. Il secondo argomento — un'enumerazione DataFormat — controlla quale formato viene scritto. Il terzo argomento è il nome del modulo; per un AcroForm senza nome, passare una stringa vuota.
L'esempio seguente carica un modulo di informazioni cliente già compilato, avvolge il suo handle del modulo in un PdfFormWidget ed esporta i valori dei campi in un file XML. Le varianti FDF e XFDF sono incluse come righe commentate: basta togliere il commento a una di esse per cambiare formato senza toccare nient'altro:
function App() {
  const exportFormData = async () => {
    // Get the Spire.PDF WASM module
    const pdfModule = window.wasmModule?.spirepdf;

    // Check that the module is ready
    if (!pdfModule) {
      alert('Spire.PDF is not ready yet');
      return;
    }

    // Load the PDF file to be exported into the VFS
    const inputFileName = 'CustomerInformationForm.pdf';
    await window.spire.FetchFileToVFS(inputFileName, "", `${process.env.PUBLIC_URL}/data/`);

    // Create a PdfDocument object and load the PDF document
    const doc = new pdfModule.PdfDocument();
    doc.LoadFromFile(inputFileName);

    // Build a PdfFormWidget from the document's form handle to reach the data export API
    const formWidget = new pdfModule.PdfFormWidget(doc.Form.H);

    // This demo exports XML
    const dataFiles = [
      { fileName: 'FormData.xml', format: pdfModule.DataFormat.Xml },
      // { fileName: 'FormData.fdf', format: pdfModule.DataFormat.Fdf },
      // { fileName: 'FormData.xfdf', format: pdfModule.DataFormat.XFdf },
    ];

    for (const item of dataFiles) {
      // The third parameter is the form name; pass an empty string for an unnamed form
      formWidget.ExportData(item.fileName, item.format, '');
    }
    doc.Close();

    // Read the generated file from the VFS and trigger the download
    for (const item of dataFiles) {
      const fileArray = window.dotnetRuntime.Module.FS.readFile(item.fileName);
      const blob = new Blob([fileArray], { type: 'application/octet-stream' });
      const url = URL.createObjectURL(blob);
      const a = document.createElement('a');
      a.href = url;
      a.download = item.fileName;
      a.click();
      URL.revokeObjectURL(url);
    }
  };

  return (
    <div style={{ textAlign: 'center', height: '300px' }}>
      <h1>Export Form Data</h1>
      <button onClick={exportFormData}>
        Export
      </button>
    </div>
  );
}

export default App;
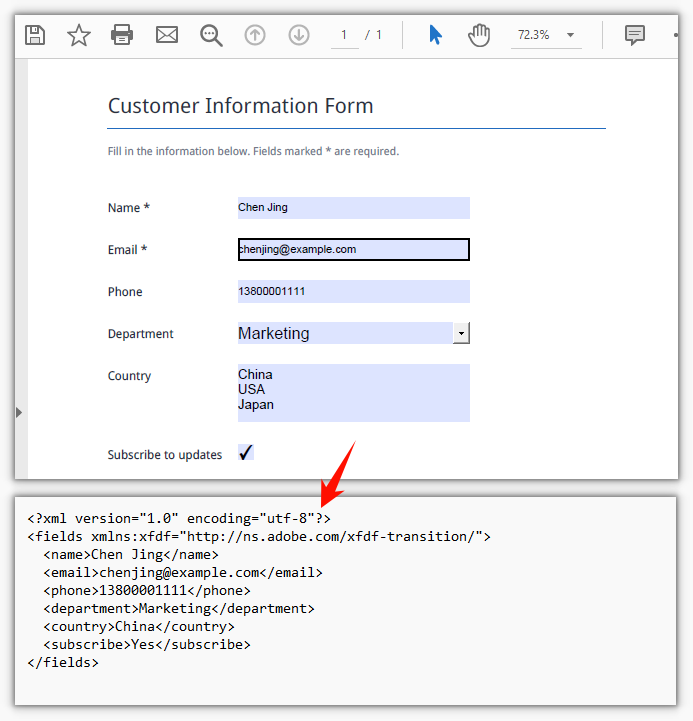
Una volta terminata la chiamata di esportazione, il file di dati risiede nel file system virtuale. Il codice poi lo rilegge dal VFS e attiva il download nel browser, così il file può essere salvato, condiviso o archiviato insieme ad altri dati del modulo:
Importare i dati di un modulo PDF
La seconda metà del ciclo è la reidratazione. PdfFormWidget.ImportData legge un file di dati e riscrive ogni valore nel campo del modulo corrispondente tramite il nome. Il parametro DataFormat indica al parser come interpretare il contenuto del file: non ha nulla a che vedere con l'estensione del file, quindi il formato dichiarato deve corrispondere al formato effettivo del file.
Il target qui è una copia vuota del modulo originale. Il modello parte vuoto; quando il file di dati ritorna, ogni campo viene popolato in un'unica passata: nessun reinserimento manuale, nessuna copia campo per campo, nessun bisogno di digitare tutto una seconda volta:
function App() {
  const importFormData = async () => {
    // Get the Spire.PDF WASM module
    const pdfModule = window.wasmModule?.spirepdf;

    // Check that the module is ready
    if (!pdfModule) {
      alert('Spire.PDF is not ready yet');
      return;
    }

    // Load the blank form to be filled into the VFS
    const inputFileName = 'BlankCustomerInformationForm.pdf';
    await window.spire.FetchFileToVFS(inputFileName, "", `${process.env.PUBLIC_URL}/data/`);

    // This demo refills from the XML data file
    const dataFiles = [
      { fileName: 'FormData.xml', format: pdfModule.DataFormat.Xml, outputFileName: 'ImportedXMLData.pdf' },
      // { fileName: 'FormData.fdf', format: pdfModule.DataFormat.Fdf, outputFileName: 'ImportedFDFData.pdf' },
      // { fileName: 'FormData.xfdf', format: pdfModule.DataFormat.XFdf, outputFileName: 'ImportedXFDFData.pdf' },
    ];

    for (const item of dataFiles) {
      // The data file also has to be loaded into the VFS first
      await window.spire.FetchFileToVFS(item.fileName, "", `${process.env.PUBLIC_URL}/data/`);

      const doc = new pdfModule.PdfDocument();
      doc.LoadFromFile(inputFileName);

      // Read the data file and write the values back into the fields by name
      const formWidget = new pdfModule.PdfFormWidget(doc.Form.H);
      formWidget.ImportData(item.fileName, item.format);

      doc.SaveToFile(item.outputFileName);
      doc.Close();

      // Read the generated file from the VFS and trigger the download
      const fileArray = window.dotnetRuntime.Module.FS.readFile(item.outputFileName);
      const blob = new Blob([fileArray], { type: 'application/pdf' });
      const url = URL.createObjectURL(blob);
      const a = document.createElement('a');
      a.href = url;
      a.download = item.outputFileName;
      a.click();
      URL.revokeObjectURL(url);
    }
  };

  return (
    <div style={{ textAlign: 'center', height: '300px' }}>
      <h1>Import Form Data</h1>
      <button onClick={importFormData}>
        Import
      </button>
    </div>
  );
}

export default App;
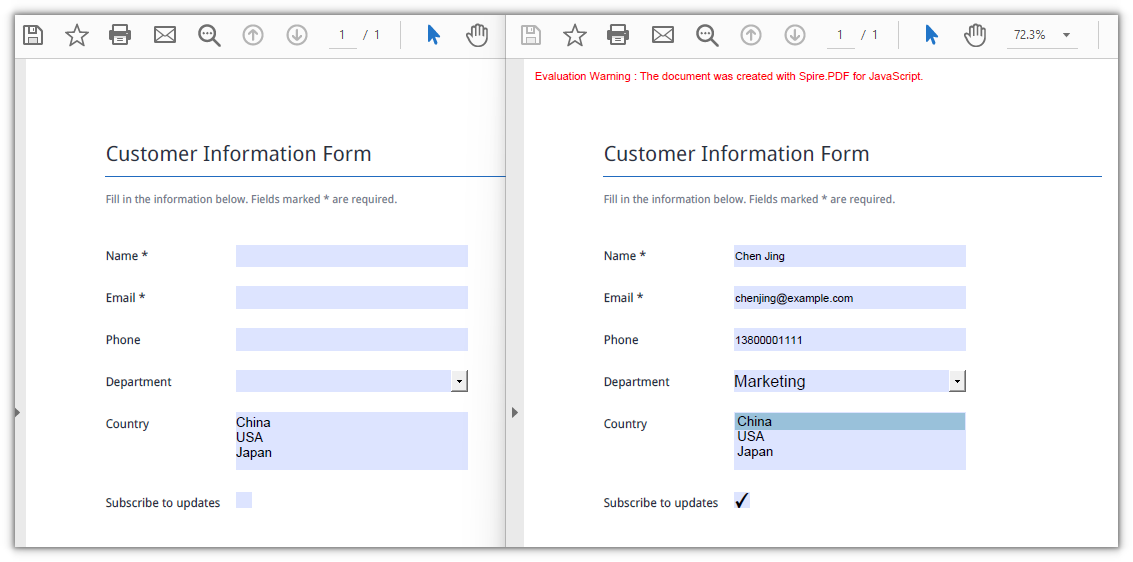
Dopo il completamento della chiamata di importazione, il modulo precedentemente vuoto è completamente popolato e pronto per essere salvato o visualizzato. Il risultato è un nuovo PDF con ogni campo compilato a partire dal file di dati:
Scegliere il formato di dati giusto
Tutti e tre i formati contengono valori dei campi identici, quindi la decisione dipende dalla struttura e dal supporto degli strumenti, non dalla fedeltà dei dati. Ecco come considerare ciascuno di essi nel contesto di un ciclo di dati di un modulo:
- FDF produce i file più piccoli. Inizia con
%FDF-e usa una notazione testuale compatta in cui/Tcontiene il nome del campo e/Vil valore. Questo lo rende efficiente per trasferire dati tra programmi che gestiscono moduli, ma il contenuto non è facilmente leggibile da una persona e non si integra bene con strumenti di testo o sistemi di controllo di versione. - XFDF è XML standard con un elemento
<field>per campo. Poiché è XML ben formato, può essere confrontato, unito e ispezionato con comuni strumenti di testo, il che lo rende la scelta più sicura quando il file di dati entra nel controllo di versione, necessita di revisione umana o deve interoperare con un altro sistema. - XML (XML dei dati di modulo Adobe) inserisce il nome del campo direttamente nel nome dell'elemento, offrendo la struttura più semplice dei tre. È ideale quando si desidera semplicemente un elenco leggibile di nomi di campo e valori senza ulteriori formalità.
In breve: usa FDF per cicli che restano all'interno di un singolo programma; usa XFDF quando il file supera i confini di strumenti o team; usa XML quando la leggibilità è la priorità assoluta.
Domande frequenti
Alcuni campi sono ancora vuoti dopo l'importazione
Causa: ImportData esegue la corrispondenza tramite il nome del campo, quindi i nomi nel file di dati devono corrispondere esattamente ai nomi dei campi nel modulo, compresi maiuscole/minuscole e spazi. Un campo che non corrisponde viene saltato silenziosamente; non c'è alcun errore né valore di ritorno che indichi una mancata corrispondenza. Solo i campi i cui nomi coincidono ricevono un valore.
Soluzione: Prima di importare, scorri la raccolta dei campi del modulo e stampa i nomi effettivi, poi confrontali con il file di dati:
const fields = formWidget.FieldsWidget;
for (let i = 0; i < fields.Count; i++) {
  console.log(fields.get_Item({ index: i }).Name);
}
L'importazione genera Xml_MessageWithErrorPosition o "not a valid FDF file"
Causa: ImportData analizza il file in base al formato indicato dal secondo parametro e non ispeziona mai l'estensione del file. Quando il contenuto non corrisponde al formato dichiarato, l'analisi fallisce immediatamente: i file XML segnalano Xml_MessageWithErrorPosition, Xml_InvalidRootData, mentre un file non FDF segnala The source is not a valid FDF file because it does not start with "%FDF-".
Soluzione: Passa il DataFormat che corrisponde al contenuto effettivo del file e usa il file di dati esportato originale anziché uno che è stato risalvato in un formato diverso.
Vedi anche
Données de formulaire PDF en aller-retour : exporter et importer avec JavaScript
Lorsqu'un formulaire PDF est rempli, les valeurs saisies se fondent avec la mise en page visuelle pour former un artefact scellé. Migrer ces saisies vers un autre modèle implique de retaper chaque champ à la main. La solution consiste à traiter les données de formulaire comme un actif portable : extraire les valeurs des champs dans un fichier de données autonome, puis les réinjecter dans une copie vierge du formulaire afin de reproduire toutes les saisies en une seule passe automatique. C'est ce cycle exportation-puis-importation que Spire.PDF for JavaScript propose au moyen de PdfFormWidget.ExportData et PdfFormWidget.ImportData.
Les deux méthodes acceptent trois formats de fichier : XML, FDF et XFDF. Passer de l'un à l'autre ne revient qu'à modifier la valeur d'une énumération DataFormat — la convention d'appel reste identique ; seule la structure du fichier de sortie sur le disque change. Comme Spire.PDF for JavaScript s'exécute entièrement dans le navigateur au-dessus de WebAssembly, l'ensemble de l'aller-retour s'effectue localement via un système de fichiers virtuel (VFS), sans serveur dorsal impliqué et sans qu'aucun document ne quitte le client.
Cet article décrit le flux de données complet :
- Exporter les données de formulaire — extraire les valeurs des champs d'un formulaire rempli
- Importer les données de formulaire — réinjecter ces valeurs dans un formulaire vierge
Pour l'installation et la configuration du projet, consultez Intégrer Spire.PDF for JavaScript dans un projet React. Les exemples ci-dessous supposent que Spire.PDF est installé et que le module WebAssembly est initialisé.
Trois formats de données de formulaire en un coup d'œil
Avant de plonger dans le code, il est utile de comprendre les trois formats avec lesquels ExportData et ImportData fonctionnent. Tous les trois transportent la même charge utile — un ensemble de paires nom de champ/valeur — mais ils l'empaquettent de manières différentes. Choisir le bon dès le départ évite bien des frictions par la suite, lorsque le fichier de données doit être partagé, inspecté ou injecté dans un autre outil.
| Format | Valeur de l'énumération | Structure du fichier | Lisible par un humain | Idéal pour |
|---|---|---|---|---|
| XML | DataFormat.Xml |
XML de données de formulaire Adobe ; le nom du champ devient le nom de l'élément, la valeur figure comme contenu de l'élément | Oui | Inspection rapide, débogage, outillage simple |
| FDF | DataFormat.Fdf |
Forms Data Format ; une structure textuelle commençant par %FDF-, où /T contient le nom du champ et /V la valeur |
Non | Transfert compact entre programmes |
| XFDF | DataFormat.XFdf |
XFDF, XML standard ; un <field name="…"> par champ, avec la valeur à l'intérieur de <value> |
Oui | Gestion de versions, échange entre systèmes |
Les trois sont sans perte en ce qui concerne les valeurs des champs — rien n'est supprimé ni transformé lors de l'exportation ou de l'importation. Le choix entre eux relève uniquement de l'adéquation au flux de travail, point sur lequel nous revenons dans le guide de sélection du format ci-dessous.
Exporter les données de formulaire PDF
La première moitié de l'aller-retour est l'extraction. PdfFormWidget.ExportData prend chaque valeur de champ du formulaire et l'écrit dans un unique fichier de données. Le deuxième argument — une énumération DataFormat — détermine le format écrit. Le troisième argument est le nom du formulaire ; pour un AcroForm sans nom, passez une chaîne vide.
L'exemple ci-dessous charge un formulaire d'informations client rempli, encapsule son descripteur de formulaire dans un PdfFormWidget et exporte les valeurs des champs vers un fichier XML. Les variantes FDF et XFDF sont incluses sous forme de lignes mises en commentaire — décommentez l'une d'elles pour changer de format sans toucher à quoi que ce soit d'autre :
function App() {
  const exportFormData = async () => {
    // Get the Spire.PDF WASM module
    const pdfModule = window.wasmModule?.spirepdf;

    // Check that the module is ready
    if (!pdfModule) {
      alert('Spire.PDF is not ready yet');
      return;
    }

    // Load the PDF file to be exported into the VFS
    const inputFileName = 'CustomerInformationForm.pdf';
    await window.spire.FetchFileToVFS(inputFileName, "", `${process.env.PUBLIC_URL}/data/`);

    // Create a PdfDocument object and load the PDF document
    const doc = new pdfModule.PdfDocument();
    doc.LoadFromFile(inputFileName);

    // Build a PdfFormWidget from the document's form handle to reach the data export API
    const formWidget = new pdfModule.PdfFormWidget(doc.Form.H);

    // This demo exports XML
    const dataFiles = [
      { fileName: 'FormData.xml', format: pdfModule.DataFormat.Xml },
      // { fileName: 'FormData.fdf', format: pdfModule.DataFormat.Fdf },
      // { fileName: 'FormData.xfdf', format: pdfModule.DataFormat.XFdf },
    ];

    for (const item of dataFiles) {
      // The third parameter is the form name; pass an empty string for an unnamed form
      formWidget.ExportData(item.fileName, item.format, '');
    }
    doc.Close();

    // Read the generated file from the VFS and trigger the download
    for (const item of dataFiles) {
      const fileArray = window.dotnetRuntime.Module.FS.readFile(item.fileName);
      const blob = new Blob([fileArray], { type: 'application/octet-stream' });
      const url = URL.createObjectURL(blob);
      const a = document.createElement('a');
      a.href = url;
      a.download = item.fileName;
      a.click();
      URL.revokeObjectURL(url);
    }
  };

  return (
    <div style={{ textAlign: 'center', height: '300px' }}>
      <h1>Export Form Data</h1>
      <button onClick={exportFormData}>
        Export
      </button>
    </div>
  );
}

export default App;
Une fois l'appel d'exportation terminé, le fichier de données réside dans le système de fichiers virtuel. Le code le relit ensuite depuis le VFS et déclenche un téléchargement par le navigateur, afin que le fichier puisse être enregistré, partagé ou archivé aux côtés d'autres données de formulaire :
Importer les données de formulaire PDF
La seconde moitié de l'aller-retour est la réhydratation. PdfFormWidget.ImportData lit un fichier de données et réécrit chaque valeur dans le champ de formulaire correspondant, par nom. Le paramètre DataFormat indique à l'analyseur comment interpréter le contenu du fichier — il n'a rien à voir avec l'extension du fichier, le format déclaré doit donc correspondre au format réel du fichier.
La cible ici est une copie vierge du formulaire d'origine. Le modèle part vide ; lorsque le fichier de données revient, chaque champ est renseigné en une seule passe — aucune ressaisie manuelle, aucune copie champ par champ, aucun besoin de tout saisir une seconde fois :
function App() {
  const importFormData = async () => {
    // Get the Spire.PDF WASM module
    const pdfModule = window.wasmModule?.spirepdf;

    // Check that the module is ready
    if (!pdfModule) {
      alert('Spire.PDF is not ready yet');
      return;
    }

    // Load the blank form to be filled into the VFS
    const inputFileName = 'BlankCustomerInformationForm.pdf';
    await window.spire.FetchFileToVFS(inputFileName, "", `${process.env.PUBLIC_URL}/data/`);

    // This demo refills from the XML data file
    const dataFiles = [
      { fileName: 'FormData.xml', format: pdfModule.DataFormat.Xml, outputFileName: 'ImportedXMLData.pdf' },
      // { fileName: 'FormData.fdf', format: pdfModule.DataFormat.Fdf, outputFileName: 'ImportedFDFData.pdf' },
      // { fileName: 'FormData.xfdf', format: pdfModule.DataFormat.XFdf, outputFileName: 'ImportedXFDFData.pdf' },
    ];

    for (const item of dataFiles) {
      // The data file also has to be loaded into the VFS first
      await window.spire.FetchFileToVFS(item.fileName, "", `${process.env.PUBLIC_URL}/data/`);

      const doc = new pdfModule.PdfDocument();
      doc.LoadFromFile(inputFileName);

      // Read the data file and write the values back into the fields by name
      const formWidget = new pdfModule.PdfFormWidget(doc.Form.H);
      formWidget.ImportData(item.fileName, item.format);

      doc.SaveToFile(item.outputFileName);
      doc.Close();

      // Read the generated file from the VFS and trigger the download
      const fileArray = window.dotnetRuntime.Module.FS.readFile(item.outputFileName);
      const blob = new Blob([fileArray], { type: 'application/pdf' });
      const url = URL.createObjectURL(blob);
      const a = document.createElement('a');
      a.href = url;
      a.download = item.outputFileName;
      a.click();
      URL.revokeObjectURL(url);
    }
  };

  return (
    <div style={{ textAlign: 'center', height: '300px' }}>
      <h1>Import Form Data</h1>
      <button onClick={importFormData}>
        Import
      </button>
    </div>
  );
}

export default App;
Une fois l'appel d'importation terminé, le formulaire auparavant vierge est entièrement renseigné et prêt à être enregistré ou affiché. Le résultat est un nouveau PDF dont chaque champ est rempli à partir du fichier de données :
Choisir le bon format de données
Les trois formats contiennent des valeurs de champs identiques, la décision repose donc sur la structure et la prise en charge par les outils plutôt que sur la fidélité des données. Voici comment envisager chacun d'eux dans le contexte d'un aller-retour de données de formulaire :
- FDF produit les fichiers les plus petits. Il commence par
%FDF-et utilise une notation textuelle compacte où/Tporte le nom du champ et/Vla valeur. Cela le rend efficace pour transmettre des données entre programmes de gestion de formulaires, mais son contenu n'est pas facilement lisible par une personne et s'accommode mal des outils de traitement de texte ou des systèmes de gestion de versions. - XFDF est du XML standard avec un élément
<field>par champ. Comme il s'agit de XML bien formé, il peut être comparé, fusionné et inspecté avec des outils textuels ordinaires, ce qui en fait le choix le plus sûr lorsque le fichier de données entre dans un système de gestion de versions, nécessite une relecture humaine ou doit interopérer avec un autre système. - XML (XML de données de formulaire Adobe) place le nom du champ directement dans le nom de l'élément, offrant la structure la plus simple des trois. Il est idéal lorsque vous voulez simplement une liste lisible de noms de champs et de valeurs, sans formalisme supplémentaire.
En bref : utilisez FDF pour les allers-retours qui restent à l'intérieur d'un même programme ; utilisez XFDF lorsque le fichier franchit les frontières d'un outil ou d'une équipe ; utilisez XML lorsque la lisibilité est la priorité absolue.
FAQ
Certains champs sont encore vides après l'importation
Cause : ImportData effectue la correspondance par nom de champ, les noms du fichier de données doivent donc correspondre exactement aux noms des champs du formulaire — y compris la casse et les espaces. Un champ qui ne correspond pas est ignoré silencieusement ; aucune erreur n'est signalée et aucune valeur de retour n'indique une non-concordance. Seuls les champs dont les noms correspondent reçoivent une valeur.
Solution : Avant l'importation, parcourez la collection de champs du formulaire et affichez les noms réels, puis comparez-les à ceux du fichier de données :
const fields = formWidget.FieldsWidget;
for (let i = 0; i < fields.Count; i++) {
  console.log(fields.get_Item({ index: i }).Name);
}
L'importation lève Xml_MessageWithErrorPosition ou « not a valid FDF file »
Cause : ImportData analyse le fichier selon le format indiqué par le deuxième paramètre et n'inspecte jamais l'extension du fichier. Lorsque le contenu ne correspond pas au format déclaré, l'analyse échoue immédiatement : les fichiers XML signalent Xml_MessageWithErrorPosition, Xml_InvalidRootData, et un fichier non-FDF signale The source is not a valid FDF file because it does not start with "%FDF-".
Solution : Passez le DataFormat qui correspond au contenu réel du fichier, et utilisez le fichier de données exporté d'origine plutôt qu'un fichier qui a été réenregistré dans un autre format.
Voir aussi
Datos de formulario PDF de ida y vuelta: exportar e importar con JavaScript
Cuando se rellena un formulario PDF, los valores introducidos se fusionan con el diseño visual en un artefacto sellado. Migrar esas entradas a una plantilla diferente significa volver a escribir cada campo a mano. La solución es tratar los datos del formulario como un activo portátil: extraer los valores de los campos en un archivo de datos independiente y luego volver a introducirlos en una copia en blanco del formulario para reproducir todas las entradas en una sola pasada automática. Este ciclo de exportación e importación es lo que Spire.PDF for JavaScript ofrece mediante PdfFormWidget.ExportData y PdfFormWidget.ImportData.
Ambos métodos aceptan tres formatos de archivo: XML, FDF y XFDF. Cambiar entre ellos no es más que cambiar un valor de enumeración DataFormat: la convención de llamada sigue siendo idéntica; solo cambia la estructura en disco del archivo de salida. Dado que Spire.PDF for JavaScript se ejecuta completamente en el navegador sobre WebAssembly, todo el ciclo se ejecuta localmente a través de un sistema de archivos virtual (VFS), sin servidor backend y sin que ningún documento salga del cliente.
Este artículo recorre el flujo de datos completo:
- Exportar datos de formulario — extraer los valores de los campos de un formulario rellenado
- Importar datos de formulario — volver a introducir esos valores en un formulario en blanco
Para la instalación y la configuración del proyecto, consulte Integrar Spire.PDF for JavaScript en un proyecto de React. Los ejemplos siguientes suponen que Spire.PDF está instalado y que el módulo WebAssembly está inicializado.
Tres formatos de datos de formulario de un vistazo
Antes de sumergirse en el código, conviene entender los tres formatos con los que trabajan ExportData e ImportData. Los tres transportan la misma carga útil —un conjunto de pares nombre de campo/valor—, pero la empaquetan de maneras diferentes. Elegir el correcto desde el principio ahorra fricción más adelante, cuando el archivo de datos deba compartirse, inspeccionarse o introducirse en otra herramienta.
| Formato | Valor de enumeración | Estructura del archivo | Legible para humanos | Ideal para |
|---|---|---|---|---|
| XML | DataFormat.Xml |
XML de datos de formulario de Adobe; el nombre del campo se convierte en el nombre del elemento, el valor se sitúa como contenido del elemento | Sí | Inspección rápida, depuración, herramientas sencillas |
| FDF | DataFormat.Fdf |
Formato de datos de formularios; una estructura de texto que comienza con %FDF-, donde /T contiene el nombre del campo y /V el valor |
No | Transferencia compacta entre programas |
| XFDF | DataFormat.XFdf |
XFDF, XML estándar; un <field name="…"> por campo, con el valor dentro de <value> |
Sí | Control de versiones, intercambio entre sistemas |
Los tres son sin pérdida con respecto a los valores de los campos: nada se descarta ni se transforma durante la exportación o la importación. La elección entre ellos se reduce únicamente a la adecuación al flujo de trabajo, a lo que volvemos en la guía de selección de formato a continuación.
Exportar datos de formulario PDF
La primera mitad del ciclo es la extracción. PdfFormWidget.ExportData toma todos los valores de los campos del formulario y los escribe en un único archivo de datos. El segundo argumento —una enumeración DataFormat— controla qué formato se escribe. El tercer argumento es el nombre del formulario; para un AcroForm sin nombre, pase una cadena vacía.
El ejemplo siguiente carga un formulario de información del cliente ya rellenado, envuelve su controlador de formulario en un PdfFormWidget y exporta los valores de los campos a un archivo XML. Las variantes FDF y XFDF se incluyen como líneas comentadas: descomente cualquiera de ellas para cambiar de formato sin tocar nada más:
function App() {
  const exportFormData = async () => {
    // Get the Spire.PDF WASM module
    const pdfModule = window.wasmModule?.spirepdf;

    // Check that the module is ready
    if (!pdfModule) {
      alert('Spire.PDF is not ready yet');
      return;
    }

    // Load the PDF file to be exported into the VFS
    const inputFileName = 'CustomerInformationForm.pdf';
    await window.spire.FetchFileToVFS(inputFileName, "", `${process.env.PUBLIC_URL}/data/`);

    // Create a PdfDocument object and load the PDF document
    const doc = new pdfModule.PdfDocument();
    doc.LoadFromFile(inputFileName);

    // Build a PdfFormWidget from the document's form handle to reach the data export API
    const formWidget = new pdfModule.PdfFormWidget(doc.Form.H);

    // This demo exports XML
    const dataFiles = [
      { fileName: 'FormData.xml', format: pdfModule.DataFormat.Xml },
      // { fileName: 'FormData.fdf', format: pdfModule.DataFormat.Fdf },
      // { fileName: 'FormData.xfdf', format: pdfModule.DataFormat.XFdf },
    ];

    for (const item of dataFiles) {
      // The third parameter is the form name; pass an empty string for an unnamed form
      formWidget.ExportData(item.fileName, item.format, '');
    }
    doc.Close();

    // Read the generated file from the VFS and trigger the download
    for (const item of dataFiles) {
      const fileArray = window.dotnetRuntime.Module.FS.readFile(item.fileName);
      const blob = new Blob([fileArray], { type: 'application/octet-stream' });
      const url = URL.createObjectURL(blob);
      const a = document.createElement('a');
      a.href = url;
      a.download = item.fileName;
      a.click();
      URL.revokeObjectURL(url);
    }
  };

  return (
    <div style={{ textAlign: 'center', height: '300px' }}>
      <h1>Export Form Data</h1>
      <button onClick={exportFormData}>
        Export
      </button>
    </div>
  );
}

export default App;
Una vez finalizada la llamada de exportación, el archivo de datos reside en el sistema de archivos virtual. A continuación, el código lo vuelve a leer desde el VFS y desencadena una descarga del navegador para que el archivo pueda guardarse, compartirse o archivarse junto con otros datos de formulario:
Importar datos de formulario PDF
La segunda mitad del ciclo es la rehidratación. PdfFormWidget.ImportData lee un archivo de datos y vuelve a escribir cada valor en el campo de formulario correspondiente por nombre. El parámetro DataFormat indica al analizador cómo interpretar el contenido del archivo; no tiene nada que ver con la extensión del archivo, por lo que el formato declarado debe coincidir con el formato real del archivo.
El objetivo aquí es una copia en blanco del formulario original. La plantilla sale vacía; cuando vuelve el archivo de datos, todos los campos se rellenan en una sola pasada: sin reintroducción manual, sin copia campo por campo, sin necesidad de teclear todo una segunda vez:
function App() {
  const importFormData = async () => {
    // Get the Spire.PDF WASM module
    const pdfModule = window.wasmModule?.spirepdf;

    // Check that the module is ready
    if (!pdfModule) {
      alert('Spire.PDF is not ready yet');
      return;
    }

    // Load the blank form to be filled into the VFS
    const inputFileName = 'BlankCustomerInformationForm.pdf';
    await window.spire.FetchFileToVFS(inputFileName, "", `${process.env.PUBLIC_URL}/data/`);

    // This demo refills from the XML data file
    const dataFiles = [
      { fileName: 'FormData.xml', format: pdfModule.DataFormat.Xml, outputFileName: 'ImportedXMLData.pdf' },
      // { fileName: 'FormData.fdf', format: pdfModule.DataFormat.Fdf, outputFileName: 'ImportedFDFData.pdf' },
      // { fileName: 'FormData.xfdf', format: pdfModule.DataFormat.XFdf, outputFileName: 'ImportedXFDFData.pdf' },
    ];

    for (const item of dataFiles) {
      // The data file also has to be loaded into the VFS first
      await window.spire.FetchFileToVFS(item.fileName, "", `${process.env.PUBLIC_URL}/data/`);

      const doc = new pdfModule.PdfDocument();
      doc.LoadFromFile(inputFileName);

      // Read the data file and write the values back into the fields by name
      const formWidget = new pdfModule.PdfFormWidget(doc.Form.H);
      formWidget.ImportData(item.fileName, item.format);

      doc.SaveToFile(item.outputFileName);
      doc.Close();

      // Read the generated file from the VFS and trigger the download
      const fileArray = window.dotnetRuntime.Module.FS.readFile(item.outputFileName);
      const blob = new Blob([fileArray], { type: 'application/pdf' });
      const url = URL.createObjectURL(blob);
      const a = document.createElement('a');
      a.href = url;
      a.download = item.outputFileName;
      a.click();
      URL.revokeObjectURL(url);
    }
  };

  return (
    <div style={{ textAlign: 'center', height: '300px' }}>
      <h1>Import Form Data</h1>
      <button onClick={importFormData}>
        Import
      </button>
    </div>
  );
}

export default App;
Una vez completada la llamada de importación, el formulario que antes estaba en blanco queda totalmente rellenado y listo para guardarse o mostrarse. El resultado es un nuevo PDF con todos los campos rellenados a partir del archivo de datos:
Elegir el formato de datos adecuado
Los tres formatos contienen valores de campo idénticos, por lo que la decisión se reduce a la estructura y la compatibilidad con herramientas, más que a la fidelidad de los datos. He aquí cómo pensar en cada uno en el contexto de un ciclo de datos de formulario:
- FDF produce los archivos más pequeños. Comienza con
%FDF-y utiliza una notación de texto compacta donde/Tcontiene el nombre del campo y/Vel valor. Esto lo hace eficiente para pasar datos entre programas de gestión de formularios, pero una persona no puede leer fácilmente su contenido y no se lleva bien con herramientas de texto ni sistemas de control de versiones. - XFDF es XML estándar con un elemento
<field>por campo. Como es XML bien formado, se puede comparar, fusionar e inspeccionar con herramientas de texto normales, lo que lo convierte en la opción más segura cuando el archivo de datos entra en control de versiones, necesita revisión humana o debe interoperar con otro sistema. - XML (XML de datos de formulario de Adobe) coloca el nombre del campo directamente en el nombre del elemento, lo que da la estructura más sencilla de las tres. Es ideal cuando simplemente se desea una lista legible de nombres de campos y valores sin ninguna complicación adicional.
En resumen: use FDF para ciclos que permanecen dentro de un solo programa; use XFDF cuando el archivo cruce fronteras de herramientas o equipos; use XML cuando la legibilidad sea la máxima prioridad.
Preguntas frecuentes
Algunos campos siguen vacíos después de la importación
Causa: ImportData coincide por nombre de campo, por lo que los nombres del archivo de datos deben coincidir exactamente con los nombres de los campos del formulario, incluidos mayúsculas/minúsculas y espacios en blanco. Un campo que no coincide se omite silenciosamente; no hay error ni valor de retorno que indique una discrepancia. Solo los campos cuyos nombres coinciden reciben un valor.
Solución: antes de importar, recorra la colección de campos del formulario e imprima los nombres reales, y luego compárelos con el archivo de datos:
const fields = formWidget.FieldsWidget;
for (let i = 0; i < fields.Count; i++) {
  console.log(fields.get_Item({ index: i }).Name);
}
La importación lanza Xml_MessageWithErrorPosition o "not a valid FDF file"
Causa: ImportData analiza el archivo según el formato indicado por el segundo parámetro y nunca inspecciona la extensión del archivo. Cuando el contenido no coincide con el formato declarado, el análisis falla de inmediato: los archivos XML informan Xml_MessageWithErrorPosition, Xml_InvalidRootData, y un archivo no FDF informa The source is not a valid FDF file because it does not start with "%FDF-".
Solución: pase el DataFormat que coincida con el contenido real del archivo y utilice el archivo de datos exportado original en lugar de uno que se haya vuelto a guardar en un formato diferente.
Véase también
PDF-Formulardaten im Round-Trip: Export und Import mit JavaScript
Wenn ein PDF-Formular ausgefüllt wird, verschmelzen die eingegebenen Werte mit dem visuellen Layout zu einem versiegelten Artefakt. Diese Einträge auf eine andere Vorlage zu übertragen bedeutet, jedes Feld von Hand neu einzugeben. Der Ausweg besteht darin, Formulardaten als portable Ressource zu behandeln: Feldwerte in eine eigenständige Datendatei extrahieren und sie dann wieder in eine leere Kopie des Formulars einzuspeisen, um alle Einträge in einem automatischen Durchlauf zu reproduzieren. Dieser Export-dann-Import-Zyklus ist das, was Spire.PDF für JavaScript durch PdfFormWidget.ExportData und PdfFormWidget.ImportData bietet.
Beide Methoden akzeptieren drei Dateiformate: XML, FDF und XFDF. Das Umschalten zwischen ihnen ist nichts weiter als das Ändern eines DataFormat-Enum-Werts – die Aufrufkonvention bleibt identisch; nur die Struktur der Ausgabedatei auf dem Datenträger ändert sich. Da Spire.PDF für JavaScript vollständig im Browser auf WebAssembly ausgeführt wird, erfolgt der gesamte Round-Trip lokal über ein virtuelles Dateisystem (VFS), ohne dass ein Backend-Server beteiligt ist und ohne dass das Dokument jemals den Client verlässt.
Dieser Artikel führt durch den vollständigen Datenfluss:
- Formulardaten exportieren — Feldwerte aus einem ausgefüllten Formular herausziehen
- Formulardaten importieren — diese Werte zurück in ein leeres Formular einspeisen
Informationen zur Installation und Projekteinrichtung finden Sie unter Spire.PDF für JavaScript in ein React-Projekt integrieren. Die folgenden Beispiele gehen davon aus, dass Spire.PDF installiert und das WebAssembly-Modul initialisiert ist.
Drei Formulardatenformate auf einen Blick
Bevor wir in den Code eintauchen, ist es hilfreich, die drei Formate zu verstehen, mit denen ExportData und ImportData arbeiten. Alle drei tragen die gleiche Nutzlast – eine Reihe von Feldname/Wert-Paaren –, verpacken sie aber auf unterschiedliche Weise. Wenn Sie von Anfang an das richtige auswählen, ersparen Sie sich später Reibung, wenn die Datendatei weitergegeben, überprüft oder in ein anderes Tool eingespeist werden muss.
| Format | Enum-Wert | Dateistruktur | Für Menschen lesbar | Am besten für |
|---|---|---|---|---|
| XML | DataFormat.Xml |
Adobe Formulardaten-XML; der Feldname wird zum Elementnamen, der Wert steht als Elementinhalt | Ja | Schnelle Überprüfung, Debugging, einfache Tools |
| FDF | DataFormat.Fdf |
Forms Data Format; eine Textstruktur, die mit %FDF- beginnt, wobei /T den Feldnamen und /V den Wert enthält |
Nein | Kompakter Datenaustausch zwischen Programmen |
| XFDF | DataFormat.XFdf |
XFDF, Standard-XML; ein <field name="…"> pro Feld, mit dem Wert in <value> |
Ja | Versionskontrolle, systemübergreifender Austausch |
Alle drei sind verlustfrei in Bezug auf die Feldwerte – beim Exportieren oder Importieren wird nichts verworfen oder transformiert. Die Wahl zwischen ihnen hängt ausschließlich von der Workflow-Eignung ab, worauf wir im Leitfaden zur Formatauswahl unten zurückkommen.
PDF-Formulardaten exportieren
Die erste Hälfte des Round-Trips ist die Extraktion. PdfFormWidget.ExportData nimmt jeden Feldwert im Formular und schreibt ihn in eine einzige Datendatei. Das zweite Argument – ein DataFormat-Enum – steuert, welches Format geschrieben wird. Das dritte Argument ist der Formularname; für ein unbenanntes AcroForm übergeben Sie eine leere Zeichenfolge.
Das folgende Beispiel lädt ein ausgefülltes Kundeninformationsformular, packt sein Formularhandle in ein PdfFormWidget und exportiert die Feldwerte in eine XML-Datei. Die FDF- und XFDF-Varianten sind als auskommentierte Zeilen enthalten – kommentieren Sie eine davon aus, um das Format zu wechseln, ohne etwas anderes zu ändern:
function App() {
  const exportFormData = async () => {
    // Get the Spire.PDF WASM module
    const pdfModule = window.wasmModule?.spirepdf;

    // Check that the module is ready
    if (!pdfModule) {
      alert('Spire.PDF is not ready yet');
      return;
    }

    // Load the PDF file to be exported into the VFS
    const inputFileName = 'CustomerInformationForm.pdf';
    await window.spire.FetchFileToVFS(inputFileName, "", `${process.env.PUBLIC_URL}/data/`);

    // Create a PdfDocument object and load the PDF document
    const doc = new pdfModule.PdfDocument();
    doc.LoadFromFile(inputFileName);

    // Build a PdfFormWidget from the document's form handle to reach the data export API
    const formWidget = new pdfModule.PdfFormWidget(doc.Form.H);

    // This demo exports XML
    const dataFiles = [
      { fileName: 'FormData.xml', format: pdfModule.DataFormat.Xml },
      // { fileName: 'FormData.fdf', format: pdfModule.DataFormat.Fdf },
      // { fileName: 'FormData.xfdf', format: pdfModule.DataFormat.XFdf },
    ];

    for (const item of dataFiles) {
      // The third parameter is the form name; pass an empty string for an unnamed form
      formWidget.ExportData(item.fileName, item.format, '');
    }
    doc.Close();

    // Read the generated file from the VFS and trigger the download
    for (const item of dataFiles) {
      const fileArray = window.dotnetRuntime.Module.FS.readFile(item.fileName);
      const blob = new Blob([fileArray], { type: 'application/octet-stream' });
      const url = URL.createObjectURL(blob);
      const a = document.createElement('a');
      a.href = url;
      a.download = item.fileName;
      a.click();
      URL.revokeObjectURL(url);
    }
  };

  return (
    <div style={{ textAlign: 'center', height: '300px' }}>
      <h1>Export Form Data</h1>
      <button onClick={exportFormData}>
        Export
      </button>
    </div>
  );
}

export default App;
Sobald der Exportaufruf abgeschlossen ist, befindet sich die Datendatei im virtuellen Dateisystem. Der Code liest sie dann aus dem VFS zurück und löst einen Browser-Download aus, damit die Datei gespeichert, weitergegeben oder zusammen mit anderen Formulardaten archiviert werden kann:
PDF-Formulardaten importieren
Die zweite Hälfte des Round-Trips ist die Rehydrierung. PdfFormWidget.ImportData liest eine Datendatei und schreibt jeden Wert anhand des Namens zurück in das passende Formularfeld. Der Parameter DataFormat teilt dem Parser mit, wie der Dateiinhalt zu interpretieren ist – er hat nichts mit der Dateiendung zu tun, daher muss das angegebene Format mit dem tatsächlichen Format der Datei übereinstimmen.
Das Ziel hier ist eine leere Kopie des Originalformulars. Die Vorlage wird leer ausgegeben; wenn die Datendatei zurückkommt, wird jedes Feld in einem einzigen Durchlauf befüllt – keine manuelle Neueingabe, kein Kopieren Feld für Feld, kein erneutes Eingeben aller Daten:
function App() {
  const importFormData = async () => {
    // Get the Spire.PDF WASM module
    const pdfModule = window.wasmModule?.spirepdf;

    // Check that the module is ready
    if (!pdfModule) {
      alert('Spire.PDF is not ready yet');
      return;
    }

    // Load the blank form to be filled into the VFS
    const inputFileName = 'BlankCustomerInformationForm.pdf';
    await window.spire.FetchFileToVFS(inputFileName, "", `${process.env.PUBLIC_URL}/data/`);

    // This demo refills from the XML data file
    const dataFiles = [
      { fileName: 'FormData.xml', format: pdfModule.DataFormat.Xml, outputFileName: 'ImportedXMLData.pdf' },
      // { fileName: 'FormData.fdf', format: pdfModule.DataFormat.Fdf, outputFileName: 'ImportedFDFData.pdf' },
      // { fileName: 'FormData.xfdf', format: pdfModule.DataFormat.XFdf, outputFileName: 'ImportedXFDFData.pdf' },
    ];

    for (const item of dataFiles) {
      // The data file also has to be loaded into the VFS first
      await window.spire.FetchFileToVFS(item.fileName, "", `${process.env.PUBLIC_URL}/data/`);

      const doc = new pdfModule.PdfDocument();
      doc.LoadFromFile(inputFileName);

      // Read the data file and write the values back into the fields by name
      const formWidget = new pdfModule.PdfFormWidget(doc.Form.H);
      formWidget.ImportData(item.fileName, item.format);

      doc.SaveToFile(item.outputFileName);
      doc.Close();

      // Read the generated file from the VFS and trigger the download
      const fileArray = window.dotnetRuntime.Module.FS.readFile(item.outputFileName);
      const blob = new Blob([fileArray], { type: 'application/pdf' });
      const url = URL.createObjectURL(blob);
      const a = document.createElement('a');
      a.href = url;
      a.download = item.outputFileName;
      a.click();
      URL.revokeObjectURL(url);
    }
  };

  return (
    <div style={{ textAlign: 'center', height: '300px' }}>
      <h1>Import Form Data</h1>
      <button onClick={importFormData}>
        Import
      </button>
    </div>
  );
}

export default App;
Nach Abschluss des Importaufrufs ist das zuvor leere Formular vollständig befüllt und bereit, gespeichert oder angezeigt zu werden. Das Ergebnis ist ein neues PDF, bei dem jedes Feld aus der Datendatei ausgefüllt ist:
Das richtige Datenformat auswählen
Alle drei Formate enthalten identische Feldwerte, sodass die Entscheidung auf Struktur und Tool-Unterstützung hinausläuft und nicht auf Datentreue. So sollten Sie jedes einzelne im Kontext eines Formulardaten-Round-Trips betrachten:
- FDF erzeugt die kleinsten Dateien. Es beginnt mit
%FDF-und verwendet eine kompakte Textnotation, bei der/Tden Feldnamen und/Vden Wert trägt. Dadurch ist es effizient für die Übergabe von Daten zwischen formularverarbeitenden Programmen, aber der Inhalt ist für Menschen nicht leicht zu lesen und harmoniert nicht gut mit Textwerkzeugen oder Versionskontrollsystemen. - XFDF ist Standard-XML mit einem
<field>-Element pro Feld. Da es sich um wohlgeformtes XML handelt, kann es mit gewöhnlichen Textwerkzeugen verglichen, zusammengeführt und überprüft werden, was es zur sichersten Wahl macht, wenn die Datendatei in die Versionskontrolle eingeht, von Menschen überprüft werden muss oder mit einem anderen System interoperieren soll. - XML (Adobe Formulardaten-XML) setzt den Feldnamen direkt in den Elementnamen, was die geradlinigste Struktur der drei ergibt. Es ist ideal, wenn Sie einfach eine lesbare Liste von Feldnamen und -werten ohne zusätzlichen Aufwand wünschen.
Kurz gesagt: Verwenden Sie FDF für Round-Trips, die innerhalb eines einzigen Programms bleiben; verwenden Sie XFDF, wenn die Datei Tool- oder Teamgrenzen überschreitet; verwenden Sie XML, wenn Lesbarkeit oberste Priorität hat.
FAQ
Einige Felder sind nach dem Import noch leer
Ursache: ImportData gleicht nach Feldnamen ab, daher müssen die Namen in der Datendatei exakt mit den Feldnamen im Formular übereinstimmen – einschließlich Groß-/Kleinschreibung und Leerzeichen. Ein Feld, das nicht übereinstimmt, wird stillschweigend übersprungen; es gibt keinen Fehler und keinen Rückgabewert, der auf eine Nichtübereinstimmung hinweist. Nur die Felder, deren Namen übereinstimmen, erhalten einen Wert.
Lösung: Bevor Sie importieren, durchlaufen Sie die Feldauflistung des Formulars und geben Sie die tatsächlichen Namen aus, und vergleichen Sie sie dann mit der Datendatei:
const fields = formWidget.FieldsWidget;
for (let i = 0; i < fields.Count; i++) {
  console.log(fields.get_Item({ index: i }).Name);
}
Import löst Xml_MessageWithErrorPosition oder "not a valid FDF file" aus
Ursache: ImportData analysiert die Datei gemäß dem durch den zweiten Parameter angegebenen Format und prüft niemals die Dateiendung. Wenn der Inhalt nicht mit dem angegebenen Format übereinstimmt, schlägt das Parsen sofort fehl: XML-Dateien melden Xml_MessageWithErrorPosition, Xml_InvalidRootData, und eine Nicht-FDF-Datei meldet The source is not a valid FDF file because it does not start with "%FDF-".
Lösung: Übergeben Sie das DataFormat, das dem tatsächlichen Inhalt der Datei entspricht, und verwenden Sie die ursprüngliche exportierte Datendatei anstelle einer, die in einem anderen Format neu gespeichert wurde.
Siehe auch
Круговой обмен данными PDF-формы: экспорт и импорт с помощью JavaScript
Когда форма PDF заполнена, введённые значения сливаются с визуальной компоновкой в единый артефакт. Перенос этих записей в другой шаблон означает повторный ручной ввод каждого поля. Выход — относиться к данным формы как к переносимому ресурсу: извлечь значения полей в отдельный файл данных, а затем подать его обратно в пустой экземпляр формы, чтобы воспроизвести все записи за один автоматический проход. Именно этот цикл «экспорт — импорт» реализует Spire.PDF for JavaScript через PdfFormWidget.ExportData и PdfFormWidget.ImportData.
Оба метода принимают три формата файлов: XML, FDF и XFDF. Переключение между ними — это не более чем изменение значения перечисления DataFormat: способ вызова остаётся тем же, меняется лишь структура выходного файла на диске. Поскольку Spire.PDF for JavaScript полностью работает в браузере на основе WebAssembly, весь цикл выполняется локально через виртуальную файловую систему (VFS), без участия серверной части, и документ никогда не покидает клиент.
В этой статье рассматривается полный поток данных:
- Экспорт данных формы — извлечение значений полей из заполненной формы
- Импорт данных формы — запись этих значений обратно в пустую форму
Информацию об установке и настройке проекта см. в разделе Интеграция Spire.PDF for JavaScript в проект React. В приведённых ниже примерах предполагается, что Spire.PDF установлен и модуль WebAssembly инициализирован.
Три формата данных форм: краткий обзор
Прежде чем переходить к коду, полезно разобраться в трёх форматах, с которыми работают ExportData и ImportData. Все три несут одну и ту же полезную нагрузку — набор пар «имя поля / значение», — но упаковывают её по-разному. Если выбрать подходящий формат сразу, позже будет меньше сложностей, когда файл данных потребуется передать, проверить или подать в другой инструмент.
| Формат | Значение перечисления | Структура файла | Читаемость для человека | Лучше всего подходит для |
|---|---|---|---|---|
| XML | DataFormat.Xml |
XML данных формы Adobe; имя поля становится именем элемента, а значение — содержимым элемента | Да | Быстрого просмотра, отладки, простых инструментов |
| FDF | DataFormat.Fdf |
Forms Data Format; текстовая структура, начинающаяся с %FDF-, где /T содержит имя поля, а /V — значение |
Нет | Компактной передачи между программами |
| XFDF | DataFormat.XFdf |
XFDF, стандартный XML; один <field name="…"> на каждое поле, значение внутри <value> |
Да | Контроля версий, обмена между системами |
Все три формата не теряют значения полей — при экспорте и импорте ничего не отбрасывается и не преобразуется. Выбор между ними определяется исключительно удобством рабочего процесса, к чему мы вернёмся в руководстве по выбору формата ниже.
Экспорт данных формы PDF
Первая половина цикла — извлечение. PdfFormWidget.ExportData берёт все значения полей формы и записывает их в один файл данных. Второй аргумент — перечисление DataFormat — определяет, в каком формате будет выполнена запись. Третий аргумент — имя формы; для неименованной AcroForm передайте пустую строку.
В приведённом ниже примере загружается заполненная форма сведений о клиенте, её дескриптор формы оборачивается в PdfFormWidget, а значения полей экспортируются в файл XML. Варианты для FDF и XFDF добавлены в виде закомментированных строк — раскомментируйте любую из них, чтобы сменить формат, не трогая ничего остального:
function App() {
  const exportFormData = async () => {
    // Get the Spire.PDF WASM module
    const pdfModule = window.wasmModule?.spirepdf;

    // Check that the module is ready
    if (!pdfModule) {
      alert('Spire.PDF is not ready yet');
      return;
    }

    // Load the PDF file to be exported into the VFS
    const inputFileName = 'CustomerInformationForm.pdf';
    await window.spire.FetchFileToVFS(inputFileName, "", `${process.env.PUBLIC_URL}/data/`);

    // Create a PdfDocument object and load the PDF document
    const doc = new pdfModule.PdfDocument();
    doc.LoadFromFile(inputFileName);

    // Build a PdfFormWidget from the document's form handle to reach the data export API
    const formWidget = new pdfModule.PdfFormWidget(doc.Form.H);

    // This demo exports XML
    const dataFiles = [
      { fileName: 'FormData.xml', format: pdfModule.DataFormat.Xml },
      // { fileName: 'FormData.fdf', format: pdfModule.DataFormat.Fdf },
      // { fileName: 'FormData.xfdf', format: pdfModule.DataFormat.XFdf },
    ];

    for (const item of dataFiles) {
      // The third parameter is the form name; pass an empty string for an unnamed form
      formWidget.ExportData(item.fileName, item.format, '');
    }
    doc.Close();

    // Read the generated file from the VFS and trigger the download
    for (const item of dataFiles) {
      const fileArray = window.dotnetRuntime.Module.FS.readFile(item.fileName);
      const blob = new Blob([fileArray], { type: 'application/octet-stream' });
      const url = URL.createObjectURL(blob);
      const a = document.createElement('a');
      a.href = url;
      a.download = item.fileName;
      a.click();
      URL.revokeObjectURL(url);
    }
  };

  return (
    <div style={{ textAlign: 'center', height: '300px' }}>
      <h1>Export Form Data</h1>
      <button onClick={exportFormData}>
        Export
      </button>
    </div>
  );
}

export default App;
После завершения вызова экспорта файл данных находится в виртуальной файловой системе. Затем код считывает его из VFS и запускает загрузку в браузере, чтобы файл можно было сохранить, передать или заархивировать вместе с другими данными форм:
Импорт данных формы PDF
Вторая половина цикла — восстановление данных. PdfFormWidget.ImportData считывает файл данных и записывает каждое значение обратно в соответствующее поле формы по имени. Параметр DataFormat указывает парсеру, как интерпретировать содержимое файла; он никак не связан с расширением файла, поэтому объявленный формат должен совпадать с фактическим форматом файла.
Целевым объектом здесь является пустой экземпляр исходной формы. Шаблон отправляется незаполненным; когда файл данных возвращается, все поля заполняются за один проход — без повторного ручного ввода, без копирования поле за полем, без необходимости вводить всё заново:
function App() {
  const importFormData = async () => {
    // Get the Spire.PDF WASM module
    const pdfModule = window.wasmModule?.spirepdf;

    // Check that the module is ready
    if (!pdfModule) {
      alert('Spire.PDF is not ready yet');
      return;
    }

    // Load the blank form to be filled into the VFS
    const inputFileName = 'BlankCustomerInformationForm.pdf';
    await window.spire.FetchFileToVFS(inputFileName, "", `${process.env.PUBLIC_URL}/data/`);

    // This demo refills from the XML data file
    const dataFiles = [
      { fileName: 'FormData.xml', format: pdfModule.DataFormat.Xml, outputFileName: 'ImportedXMLData.pdf' },
      // { fileName: 'FormData.fdf', format: pdfModule.DataFormat.Fdf, outputFileName: 'ImportedFDFData.pdf' },
      // { fileName: 'FormData.xfdf', format: pdfModule.DataFormat.XFdf, outputFileName: 'ImportedXFDFData.pdf' },
    ];

    for (const item of dataFiles) {
      // The data file also has to be loaded into the VFS first
      await window.spire.FetchFileToVFS(item.fileName, "", `${process.env.PUBLIC_URL}/data/`);

      const doc = new pdfModule.PdfDocument();
      doc.LoadFromFile(inputFileName);

      // Read the data file and write the values back into the fields by name
      const formWidget = new pdfModule.PdfFormWidget(doc.Form.H);
      formWidget.ImportData(item.fileName, item.format);

      doc.SaveToFile(item.outputFileName);
      doc.Close();

      // Read the generated file from the VFS and trigger the download
      const fileArray = window.dotnetRuntime.Module.FS.readFile(item.outputFileName);
      const blob = new Blob([fileArray], { type: 'application/pdf' });
      const url = URL.createObjectURL(blob);
      const a = document.createElement('a');
      a.href = url;
      a.download = item.outputFileName;
      a.click();
      URL.revokeObjectURL(url);
    }
  };

  return (
    <div style={{ textAlign: 'center', height: '300px' }}>
      <h1>Import Form Data</h1>
      <button onClick={importFormData}>
        Import
      </button>
    </div>
  );
}

export default App;
После завершения вызова импорта ранее пустая форма полностью заполнена и готова к сохранению или отображению. Результат — новый PDF, в котором каждое поле заполнено данными из файла данных:
Выбор подходящего формата данных
Все три формата содержат идентичные значения полей, поэтому решение сводится к структуре и поддержке инструментами, а не к точности данных. Вот как следует думать о каждом из них в контексте цикла экспорта-импорта данных формы:
- FDF создаёт файлы наименьшего размера. Он начинается с
%FDF-и использует компактную текстовую нотацию, где/Tсодержит имя поля, а/V— значение. Это делает его эффективным для передачи данных между программами, работающими с формами, однако содержимое нелегко прочитать человеку, и он плохо сочетается с текстовыми инструментами и системами контроля версий. - XFDF — это стандартный XML с одним элементом
<field>на каждое поле. Поскольку это корректно сформированный XML, его можно сравнивать, объединять и просматривать обычными текстовыми инструментами, что делает его самым безопасным выбором, когда файл данных попадает в систему контроля версий, требует проверки человеком или должен взаимодействовать с другой системой. - XML (XML данных формы Adobe) помещает имя поля непосредственно в имя элемента, обеспечивая самую простую структуру из трёх. Он идеален, когда нужно просто получить читаемый список имён полей и значений без лишних формальностей.
Коротко: используйте FDF для циклов, которые остаются внутри одной программы; XFDF — когда файл пересекает границы инструментов или команд; XML — когда читаемость является главным приоритетом.
Часто задаваемые вопросы
Некоторые поля остаются пустыми после импорта
Причина: ImportData сопоставляет данные по имени поля, поэтому имена в файле данных должны в точности совпадать с именами полей в форме — включая регистр и пробелы. Поле, которое не совпало, молча пропускается; ошибки нет и нет возвращаемого значения, указывающего на несовпадение. Значение получают только те поля, чьи имена совпали.
Решение: Перед импортом пройдите по коллекции полей формы и выведите их фактические имена, затем сравните их с файлом данных:
const fields = formWidget.FieldsWidget;
for (let i = 0; i < fields.Count; i++) {
  console.log(fields.get_Item({ index: i }).Name);
}
При импорте возникает ошибка Xml_MessageWithErrorPosition или «not a valid FDF file»
Причина: ImportData разбирает файл в соответствии с форматом, указанным во втором параметре, и никогда не проверяет расширение файла. Когда содержимое не соответствует объявленному формату, разбор немедленно завершается ошибкой: для XML-файлов сообщается Xml_MessageWithErrorPosition, Xml_InvalidRootData, а для файла, не являющегося FDF, — The source is not a valid FDF file because it does not start with "%FDF-".
Решение: Передайте DataFormat, соответствующий фактическому содержимому файла, и используйте исходный экспортированный файл данных, а не тот, который был повторно сохранён в другом формате.
См. также
Aparar Páginas PDF: Recorte Margens e Espaços em Branco com JavaScript
Os PDFs frequentemente carregam mais espaço em branco do que o necessário — documentos digitalizados com bordas espessas, desenhos de engenharia com margens generosas ou faturas em que apenas a tabela central importa. Recortar a página é a correção natural, mas fazer isso em um fluxo de trabalho baseado em navegador não é simples. Ferramentas de desktop quebram a experiência web, e enviar o arquivo para um servidor de back-end levanta preocupações de privacidade e conformidade.
É aqui que o Spire.PDF for JavaScript entra. Ele é executado em WebAssembly e opera inteiramente dentro do navegador, carregando e salvando PDFs por meio de um sistema de arquivos virtual (VFS) sem ida e volta ao servidor. Você pode definir a área visível de cada página programaticamente e permitir que o usuário baixe o resultado recortado — tudo no lado do cliente. Para instalação e configuração do projeto, consulte Integrar o Spire.PDF for JavaScript em um projeto React. Os exemplos abaixo pressupõem que o Spire.PDF está instalado e o módulo WebAssembly está inicializado.
CropBox e MediaBox: Duas Caixas de Página Explicadas
Cada página de PDF é definida por dois retângulos, e entender a diferença entre eles é essencial antes de começar a recortar.
MediaBox descreve as dimensões físicas da página — a folha de papel inteira, por assim dizer. É o limite mais externo e define o espaço de coordenadas no qual todo o conteúdo é posicionado. Uma página A4 padrão tem um MediaBox de aproximadamente 595 × 842 pontos.
CropBox define o que o visualizador realmente exibe. É uma sub-região do MediaBox, e qualquer conteúdo que fique fora do CropBox é ocultado da visualização. Por padrão, o CropBox corresponde ao MediaBox, e é por isso que normalmente você vê a página inteira. Quando você reduz o CropBox, está efetivamente dizendo ao leitor de PDF: "Mostre apenas esta parte da página."
O ponto-chave para o recorte é que o CropBox é derivado do MediaBox. Você lê as dimensões completas da página em page.MediaBox.Width e page.MediaBox.Height, depois calcula um retângulo menor — reduzido pela margem que desejar em cada lado — e o atribui a page.CropBox. As coordenadas x e y do CropBox são medidas a partir do canto superior esquerdo da página, e width e height determinam quanto da página é mantido.
Recortar Todas as Páginas com uma Margem Uniforme
O cenário mais comum é aplicar a mesma redução de margem a todas as páginas de um documento. Você itera sobre doc.Pages, lê o MediaBox de cada página e define um CropBox que é reduzido por um número fixo de pontos nos quatro lados.
O exemplo abaixo remove 60 pontos de cada borda de cada página — o suficiente para remover uma borda branca larga ou uma moldura indesejada:
function App() {
  const cropPdfPage = async () => {
    // Get the Spire.PDF WASM module
    const pdfModule = window.wasmModule?.spirepdf;

    // Check whether the module is ready
    if (!pdfModule) {
      alert('Spire.PDF is not ready yet');
      return;
    }

    // Load the PDF file to be cropped into the VFS
    const inputFileName = 'ToCrop.pdf';
    await window.spire.FetchFileToVFS(inputFileName, "", `${process.env.PUBLIC_URL}/data/`);

    // Create a PdfDocument object and load the PDF document
    let doc = new pdfModule.PdfDocument();
    doc.LoadFromFile(inputFileName);

    // Trim 60 points off every side
    const margin = 60;

    for (let i = 0; i < doc.Pages.Count; i++) {
      const page = doc.Pages.get_Item(i);

      // MediaBox gives the full extent of the page, from which the crop box is derived
      // (x and y are measured from the top-left corner of the page)
      const width = page.MediaBox.Width;
      const height = page.MediaBox.Height;

      page.CropBox = new pdfModule.RectangleF({
        x: margin,
        y: margin,
        width: width - margin * 2,
        height: height - margin * 2,
      });
    }

    const outputFileName = 'CropByMargins.pdf';
    doc.SaveToFile(outputFileName);
    doc.Close();

    // Read the generated file from the VFS and trigger the download
    const fileArray = window.dotnetRuntime.Module.FS.readFile(outputFileName);
    const blob = new Blob([fileArray], { type: 'application/pdf' });
    const url = URL.createObjectURL(blob);
    const a = document.createElement('a');
    a.href = url;
    a.download = outputFileName;
    a.click();
    URL.revokeObjectURL(url);
  };

  return (
    <div style={{ textAlign: 'center', height: '300px' }}>
      <h1>Crop PDF Pages</h1>
      <button onClick={cropPdfPage}>
        Crop PDF
      </button>
    </div>
  );
}

export default App;
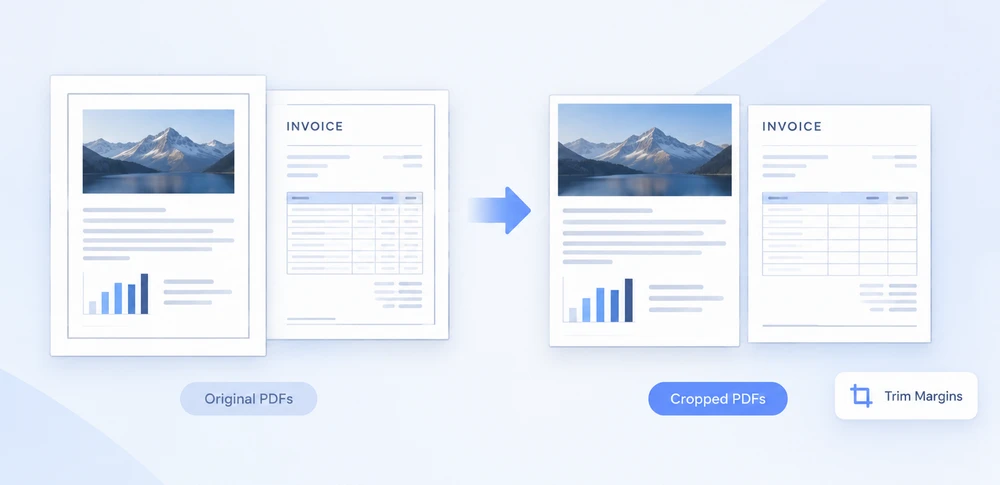
Ambas as páginas são recortadas por uma margem de 60 pontos, de modo que a margem branca e a moldura ao redor da página são removidas:
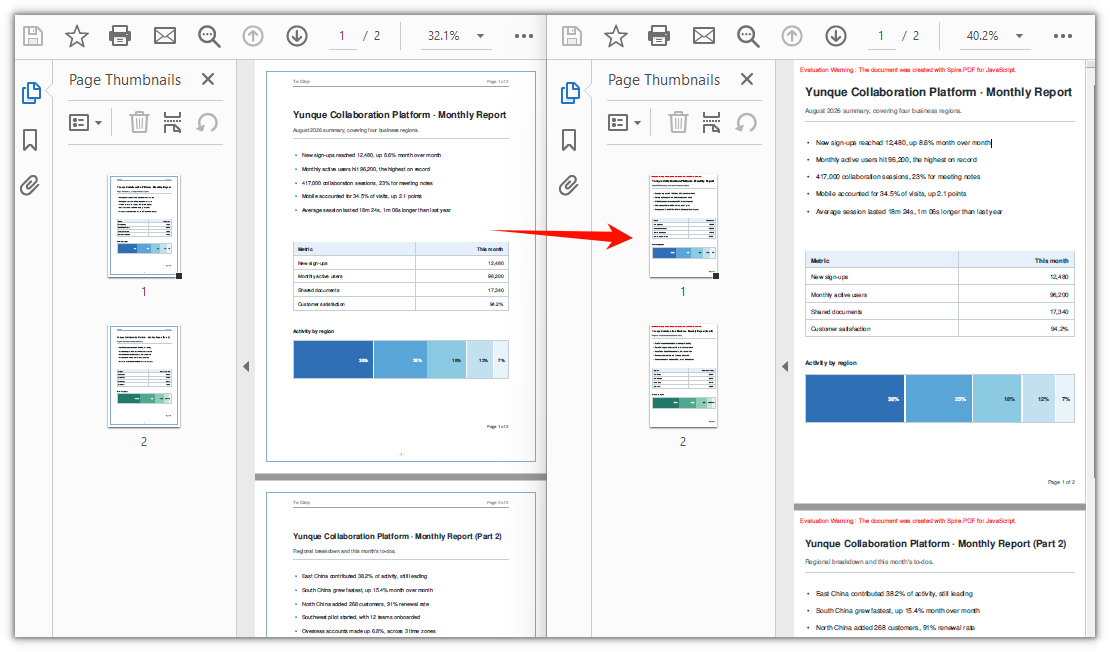
Ajuste o valor de margin para controlar quão agressivamente a página é recortada. Um valor maior remove mais espaço em branco; um valor menor realiza um recorte mais sutil. Como a margem é aplicada uniformemente aos quatro lados, esta abordagem funciona melhor quando a borda indesejada é aproximadamente igual em todas as extremidades — o que normalmente é o caso de documentos digitalizados e desenhos exportados.
Recorte de Página Única vs Documento Inteiro
O loop da seção anterior aplica o mesmo recorte a todas as páginas. Mas CropBox é uma propriedade em nível de página — não existe uma interface de recorte para todo o documento. O loop simplesmente garante que cada página receba a mesma margem. Essa distinção importa quando suas páginas têm necessidades diferentes.
Quando recortar o documento inteiro: Use a abordagem com loop quando todas as páginas compartilham o mesmo problema — por exemplo, um lote digitalizado em que cada página tem a mesma borda do scanner, ou um conjunto de desenhos de várias páginas exportado com margens idênticas. Um único valor de margin mantém o código simples e o resultado consistente.
Quando recortar uma única página: Remova o loop e atribua o CropBox diretamente à página desejada. Isso é útil quando apenas uma página precisa ser recortada — por exemplo, uma capa com um logotipo superdimensionado, ou uma fatura em que apenas a região da tabela na página 2 deve ser visível. Você também pode aplicar valores de recorte diferentes a páginas diferentes combinando lógica por página dentro do loop.
Veja como recortar apenas a primeira página, mantendo um bloco de 400 × 500 pontos começando na posição (80, 80) a partir do canto superior esquerdo:
// Crop page 1 only: keep a 400 x 500 point block starting at (80, 80) from the top-left corner
const page = doc.Pages.get_Item(0);
page.CropBox = new pdfModule.RectangleF({ x: 80, y: 80, width: 400, height: 500 });
Os valores de x e y especificam onde a região visível começa, medidos a partir do canto superior esquerdo da página. Os valores de width e height definem o tamanho dessa região. Tudo fora desse retângulo é ocultado do visualizador.
Recorte Suave: O Que Acontece com o Conteúdo
Há um detalhe importante sobre o CropBox que é fácil de ignorar: ele realiza um recorte suave, não um recorte rígido.
Quando você define o CropBox, está alterando o limite visível da página — o retângulo que os visualizadores de PDF exibem e que as impressoras usam como área da página. Mas o conteúdo que fica fora desse limite não é removido do arquivo. Ele ainda está lá, apenas oculto. Isso tem duas consequências práticas:
O tamanho do arquivo não diminui. O texto, as imagens e os gráficos vetoriais recortados permanecem no fluxo de dados do PDF. Se seu objetivo é reduzir o tamanho do arquivo recortando margens, definir apenas o CropBox não alcançará isso.
O conteúdo recortado ainda é pesquisável. O texto fora do CropBox visível ainda pode ser encontrado por funções de pesquisa e copiado por usuários que sabem como selecionar além da área visível. Isso geralmente é aceitável para recorte de margens, mas significa que o recorte não é uma forma de censurar ou remover com segurança informações sensíveis.
Se você precisa realmente eliminar conteúdo — para censura, redução do tamanho do arquivo ou para garantir que texto oculto não possa ser recuperado —, deve reconstruir a página. A abordagem é criar um novo documento, extrair o conteúdo visível da página recortada usando page.CreateTemplate(), desenhá-lo em uma nova página no novo documento e salvar o resultado. Isso produz um recorte rígido em que o conteúdo fora dos limites não existe mais no arquivo.
Para a maioria dos casos de uso de recorte de margens e remoção de espaços em branco, no entanto, o recorte suave com CropBox é exatamente o que você deseja: é rápido, simples e produz um resultado visualmente limpo sem a sobrecarga de reconstruir o documento.
Perguntas Frequentes
Posso recortar uma única página em vez do documento inteiro?
Sim. Como CropBox é uma propriedade por página, não há um método integrado de "recortar o documento inteiro" — o loop do exemplo principal é apenas uma conveniência para aplicar a mesma margem a todas as páginas. Para recortar apenas uma página, pule o loop e atribua o CropBox diretamente a essa página:
// Crop page 1 only: keep a 400 x 500 point block starting at (80, 80) from the top-left corner
const page = doc.Pages.get_Item(0);
page.CropBox = new pdfModule.RectangleF({ x: 80, y: 80, width: 400, height: 500 });
Como desfaço um recorte?
Definir CropBox modifica a caixa da página no local, e o documento não armazena a caixa anterior. Você pode esperar que atribuir page.MediaBox de volta a page.CropBox restaurasse a visualização original, mas isso não funciona como pretendido — as coordenadas são aplicadas em relação à origem da área visível atual, então apenas as dimensões mudam enquanto a origem permanece fixa. Após um recorte de 60 pontos, reatribuir as dimensões do MediaBox ainda deixa a área visível começando em (60, 60).
A solução mais simples é recarregar o arquivo original, se você ainda o tiver. Se apenas o arquivo recortado estiver disponível, você pode deslocar a origem de volta para o canto superior esquerdo usando deslocamentos negativos e restaurar as dimensões completas da página:
// Undo when the crop offset was (offsetX, offsetY)
page.CropBox = new pdfModule.RectangleF({
  x: -offsetX,
  y: -offsetY,
  width: page.MediaBox.Width,
  height: page.MediaBox.Height,
});
O arquivo não ficou menor e o conteúdo recortado ainda é pesquisável — por quê?
Esse é o comportamento esperado. O CropBox realiza um recorte suave: ele altera apenas o limite visível da página, enquanto o conteúdo fora desse limite permanece no arquivo e ainda pode ser encontrado por pesquisa de texto ou operações de cópia. Se você precisa remover fisicamente o conteúdo do PDF, definir o CropBox não é suficiente — você precisaria reconstruir a página criando um novo documento, extraindo o conteúdo visível com page.CreateTemplate(), desenhando-o em uma nova página e salvando em um novo arquivo.
Veja Também
PDF 페이지 자르기: JavaScript로 여백과 공백 크롭하기
PDF는 필요한 것보다 더 많은 여백을 포함하는 경우가 많습니다 — 두꺼운 테두리가 있는 스캔 문서, 여유로운 여백이 있는 엔지니어링 도면, 또는 중앙의 표만 중요한 인보이스 등이 그렇습니다. 페이지를 자르는 것이 자연스러운 해결책이지만, 브라우저 기반 워크플로에서 이를 수행하는 것은 간단하지 않습니다. 데스크톱 도구는 웹 경험을 깨뜨리고, 파일을 백엔드 서버로 보내는 것은 개인정보 및 규정 준수 문제를 일으킬 수 있습니다.
이때 Spire.PDF for JavaScript가 등장합니다. 이는 WebAssembly에서 실행되며 전적으로 브라우저 내부에서 동작하여, 서버 왕복 없이 가상 파일 시스템(VFS)을 통해 PDF를 로드하고 저장합니다. 각 페이지의 표시 영역을 프로그래밍 방식으로 설정하고 사용자가 잘린 결과를 다운로드하도록 할 수 있습니다 — 모두 클라이언트 측에서 말입니다. 설치 및 프로젝트 설정은 React 프로젝트에서 Spire.PDF for JavaScript 통합하기를 참조하십시오. 아래 예제는 Spire.PDF가 설치되고 WebAssembly 모듈이 초기화되었다고 가정합니다.
CropBox와 MediaBox: 두 가지 페이지 상자 설명
모든 PDF 페이지는 두 개의 사각형으로 정의되며, 자르기를 시작하기 전에 이들 간의 차이를 이해하는 것이 필수적입니다.
MediaBox는 페이지의 물리적 크기, 말하자면 전체 종이를 나타냅니다. 이는 가장 바깥쪽 경계이며 모든 콘텐츠가 배치되는 좌표 공간을 정의합니다. 표준 A4 페이지의 MediaBox는 약 595 × 842포인트입니다.
CropBox는 뷰어가 실제로 표시하는 영역을 정의합니다. 이는 MediaBox의 하위 영역이며, CropBox 밖에 있는 콘텐츠는 보기에서 숨겨집니다. 기본적으로 CropBox는 MediaBox와 일치하므로 일반적으로 전체 페이지가 표시됩니다. CropBox를 줄이면 PDF 리더에게 "페이지의 이 부분만 표시하세요."라고 말하는 것과 같습니다.
자르기의 핵심은 CropBox가 MediaBox에서 파생된다는 점입니다. page.MediaBox.Width와 page.MediaBox.Height에서 전체 페이지 크기를 읽은 다음, 각 변에 원하는 여백만큼 안쪽으로 들어간 더 작은 사각형을 계산하여 page.CropBox에 할당합니다. CropBox의 x 및 y 좌표는 페이지의 왼쪽 위 모서리에서 측정되며, width와 height는 페이지 중 얼마나 유지되는지를 결정합니다.
모든 페이지를 균일한 여백으로 자르기
가장 일반적인 시나리오는 문서의 모든 페이지에 동일한 여백 감소를 적용하는 것입니다. doc.Pages를 반복하면서 각 페이지의 MediaBox를 읽고, 네 변 모두에서 고정된 포인트 수만큼 안쪽으로 들어간 CropBox를 설정합니다.
아래 예제는 모든 페이지의 각 변에서 60포인트를 잘라냅니다 — 넓은 흰색 테두리나 원치 않는 프레임을 제거하기에 충분합니다:
function App() {
  const cropPdfPage = async () => {
    // Get the Spire.PDF WASM module
    const pdfModule = window.wasmModule?.spirepdf;

    // Check whether the module is ready
    if (!pdfModule) {
      alert('Spire.PDF is not ready yet');
      return;
    }

    // Load the PDF file to be cropped into the VFS
    const inputFileName = 'ToCrop.pdf';
    await window.spire.FetchFileToVFS(inputFileName, "", `${process.env.PUBLIC_URL}/data/`);

    // Create a PdfDocument object and load the PDF document
    let doc = new pdfModule.PdfDocument();
    doc.LoadFromFile(inputFileName);

    // Trim 60 points off every side
    const margin = 60;

    for (let i = 0; i < doc.Pages.Count; i++) {
      const page = doc.Pages.get_Item(i);

      // MediaBox gives the full extent of the page, from which the crop box is derived
      // (x and y are measured from the top-left corner of the page)
      const width = page.MediaBox.Width;
      const height = page.MediaBox.Height;

      page.CropBox = new pdfModule.RectangleF({
        x: margin,
        y: margin,
        width: width - margin * 2,
        height: height - margin * 2,
      });
    }

    const outputFileName = 'CropByMargins.pdf';
    doc.SaveToFile(outputFileName);
    doc.Close();

    // Read the generated file from the VFS and trigger the download
    const fileArray = window.dotnetRuntime.Module.FS.readFile(outputFileName);
    const blob = new Blob([fileArray], { type: 'application/pdf' });
    const url = URL.createObjectURL(blob);
    const a = document.createElement('a');
    a.href = url;
    a.download = outputFileName;
    a.click();
    URL.revokeObjectURL(url);
  };

  return (
    <div style={{ textAlign: 'center', height: '300px' }}>
      <h1>Crop PDF Pages</h1>
      <button onClick={cropPdfPage}>
        Crop PDF
      </button>
    </div>
  );
}

export default App;
두 페이지 모두 60포인트 여백으로 잘려서 페이지 주변의 흰색 여백과 프레임이 제거됩니다:
margin 값을 조정하여 페이지가 얼마나 공격적으로 잘릴지 제어합니다. 값이 클수록 더 많은 여백이 제거되고, 값이 작을수록 더 미묘하게 잘립니다. 여백이 네 변 모두에 균일하게 적용되므로, 이 접근 방식은 원치 않는 테두리가 모든 변에서 거의 동일할 때 가장 잘 작동합니다 — 일반적으로 스캔 문서와 내보낸 도면에서 그렇습니다.
단일 페이지 대 전체 문서 자르기
이전 섹션의 루프는 모든 페이지에 동일한 자르기를 적용합니다. 하지만 CropBox는 페이지 수준 속성이므로 문서 전체에 적용되는 자르기 인터페이스는 없습니다. 루프는 단순히 각 페이지가 동일한 여백을 받도록 보장합니다. 이 구분은 페이지마다 요구 사항이 다를 때 중요합니다.
전체 문서를 자를 때: 모든 페이지가 동일한 문제를 공유할 때 루프 접근 방식을 사용하십시오 — 예를 들어 모든 페이지에 동일한 스캐너 테두리가 있는 스캔 배치나, 동일한 여백으로 내보낸 여러 페이지 도면 세트가 그렇습니다. 단일 margin 값을 사용하면 코드가 단순해지고 결과가 일관됩니다.
단일 페이지를 자를 때: 루프를 제거하고 대상 페이지에 CropBox를 직접 할당하십시오. 한 페이지만 잘라야 할 때 유용합니다 — 예를 들어 너무 큰 로고가 있는 표지 페이지나, 2페이지의 표 영역만 표시되어야 하는 인보이스가 그렇습니다. 루프 내부에 페이지별 로직을 결합하여 페이지마다 다른 자르기 값을 적용할 수도 있습니다.
다음은 첫 번째 페이지만 자르는 방법으로, 왼쪽 위 모서리에서 (80, 80) 위치에서 시작하는 400 × 500포인트 블록을 유지합니다:
// Crop page 1 only: keep a 400 x 500 point block starting at (80, 80) from the top-left corner
const page = doc.Pages.get_Item(0);
page.CropBox = new pdfModule.RectangleF({ x: 80, y: 80, width: 400, height: 500 });
x 및 y 값은 페이지의 왼쪽 위 모서리에서 측정된, 표시 영역이 시작하는 위치를 지정합니다. width와 height 값은 해당 영역의 크기를 정의합니다. 이 사각형 밖의 모든 것은 뷰어에서 숨겨집니다.
소프트 자르기: 콘텐츠에 발생하는 일
CropBox에 대해 간과하기 쉬운 중요한 세부 사항이 있습니다: 이는 소프트 자르기를 수행하며, 하드 자르기가 아닙니다.
CropBox를 설정하면 페이지의 표시 경계, 즉 PDF 뷰어가 표시하고 프린터가 페이지 영역으로 사용하는 사각형을 변경하는 것입니다. 하지만 이 경계 밖에 있는 콘텐츠는 파일에서 제거되지 않습니다. 여전히 존재하며, 단지 숨겨져 있을 뿐입니다. 이로 인해 두 가지 실질적인 결과가 발생합니다:
파일 크기는 줄어들지 않습니다. 잘려 나간 텍스트, 이미지 및 벡터 그래픽은 PDF 데이터 스트림에 남아 있습니다. 여백을 잘라 파일 크기를 줄이는 것이 목표라면 CropBox만 설정하는 것으로는 달성할 수 없습니다.
잘린 콘텐츠는 여전히 검색할 수 있습니다. 표시되는 CropBox 밖의 텍스트는 검색 기능으로 여전히 찾을 수 있으며, 표시 영역 너머를 선택하는 방법을 아는 사용자가 복사할 수 있습니다. 이는 일반적으로 여백 자르기에는 괜찮지만, 자르기가 민감한 정보를 삭제하거나 안전하게 제거하는 방법이 아니라는 의미입니다.
콘텐츠를 진정으로 제거해야 하는 경우 — 삭제(redaction), 파일 크기 축소 또는 숨겨진 텍스트를 복구할 수 없도록 보장하기 위해 — 페이지를 다시 작성해야 합니다. 방법은 새 문서를 만들고, page.CreateTemplate()을 사용하여 잘린 페이지에서 표시되는 콘텐츠를 추출하고, 새 문서의 새 페이지에 그린 다음 결과를 저장하는 것입니다. 이렇게 하면 범위를 벗어난 콘텐츠가 파일에 더 이상 존재하지 않는 하드 자르기가 생성됩니다.
그러나 대부분의 여백 자르기 및 공백 제거 사용 사례에서는 CropBox를 사용한 소프트 자르기가 바로 원하는 것입니다: 빠르고 간단하며, 문서를 다시 작성하는 오버헤드 없이 시각적으로 깔끔한 결과를 생성합니다.
자주 묻는 질문
전체 문서 대신 단일 페이지를 자를 수 있나요?
예. CropBox는 페이지별 속성이므로 내장된 "전체 문서 자르기" 메서드는 없습니다 — 기본 예제의 루프는 모든 페이지에 동일한 여백을 적용하기 위한 편의 기능일 뿐입니다. 한 페이지만 자르려면 루프를 건너뛰고 해당 페이지에 CropBox를 직접 할당하십시오:
// Crop page 1 only: keep a 400 x 500 point block starting at (80, 80) from the top-left corner
const page = doc.Pages.get_Item(0);
page.CropBox = new pdfModule.RectangleF({ x: 80, y: 80, width: 400, height: 500 });
자르기를 실행 취소하려면 어떻게 하나요?
CropBox를 설정하면 페이지 상자가 제자리에서 수정되며, 문서는 이전 상자를 저장하지 않습니다. page.MediaBox를 다시 page.CropBox에 할당하면 원래 보기가 복원될 것이라고 생각할 수 있지만, 의도한 대로 작동하지 않습니다 — 좌표가 현재 표시 영역의 원점을 기준으로 적용되므로 원점은 고정된 채 크기만 변경됩니다. 60포인트 자르기 후 MediaBox 크기를 다시 할당해도 표시 영역은 여전히 (60, 60)에서 시작합니다.
가장 간단한 해결책은 원본 파일이 아직 있다면 다시 로드하는 것입니다. 잘린 파일만 있는 경우 음수 오프셋을 사용하여 원점을 왼쪽 위 모서리로 되돌리고 전체 페이지 크기를 복원할 수 있습니다:
// Undo when the crop offset was (offsetX, offsetY)
page.CropBox = new pdfModule.RectangleF({
  x: -offsetX,
  y: -offsetY,
  width: page.MediaBox.Width,
  height: page.MediaBox.Height,
});
파일이 작아지지 않았고 잘린 콘텐츠가 여전히 검색 가능한 이유는 무엇인가요?
이는 예상된 동작입니다. CropBox는 소프트 자르기를 수행합니다: 페이지의 표시 경계만 변경하며, 그 경계 밖의 콘텐츠는 파일에 남아 있어 텍스트 검색이나 복사 작업으로 여전히 찾을 수 있습니다. PDF에서 콘텐츠를 물리적으로 제거해야 하는 경우 CropBox 설정만으로는 충분하지 않습니다 — 새 문서를 만들고, page.CreateTemplate()으로 표시되는 콘텐츠를 추출하고, 새 페이지에 그린 다음 새 파일로 저장하여 페이지를 다시 작성해야 합니다.
참고 항목
Ritaglia pagine PDF: taglia margini e spazi bianchi con JavaScript
Spesso i PDF contengono più spazio bianco di quanto sia necessario — documenti scansionati con bordi spessi, disegni tecnici con margini ampi o fatture in cui conta solo la tabella centrale. Ritagliare la pagina è la soluzione naturale, ma farlo in un flusso di lavoro basato su browser non è semplice. Gli strumenti desktop compromettono l'esperienza web e l'invio del file a un server backend solleva problemi di privacy e conformità.
È qui che entra in gioco Spire.PDF for JavaScript. Funziona su WebAssembly e opera interamente all'interno del browser, caricando e salvando PDF tramite un file system virtuale (VFS) senza alcun round-trip al server. È possibile impostare a livello di codice l'area visibile di ogni pagina e consentire all'utente di scaricare il risultato ritagliato — tutto lato client. Per l'installazione e la configurazione del progetto, fare riferimento a Integra Spire.PDF for JavaScript in un progetto React. Gli esempi seguenti presuppongono che Spire.PDF sia installato e che il modulo WebAssembly sia inizializzato.
CropBox e MediaBox: spiegazione delle due caselle di pagina
Ogni pagina PDF è definita da due rettangoli, e comprendere la differenza tra loro è essenziale prima di iniziare a ritagliare.
MediaBox descrive le dimensioni fisiche della pagina — il foglio di carta completo, per così dire. È il confine più esterno e definisce lo spazio di coordinate in cui viene posizionato tutto il contenuto. Una pagina A4 standard ha un MediaBox di circa 595 × 842 punti.
CropBox definisce ciò che il visualizzatore mostra effettivamente. È una sotto-regione del MediaBox e qualsiasi contenuto che cade al di fuori del CropBox viene nascosto alla vista. Per impostazione predefinita, il CropBox corrisponde al MediaBox, ed è per questo che normalmente si vede l'intera pagina. Quando si riduce il CropBox, si sta effettivamente dicendo al lettore PDF: "Mostra solo questa porzione della pagina."
L'intuizione chiave per il ritaglio è che il CropBox deriva dal MediaBox. Si leggono le dimensioni complete della pagina da page.MediaBox.Width e page.MediaBox.Height, poi si calcola un rettangolo più piccolo — rientrato del margine desiderato su ciascun lato — e lo si assegna a page.CropBox. Le coordinate x e y del CropBox sono misurate dall'angolo in alto a sinistra della pagina, mentre width e height determinano quanto della pagina viene mantenuto.
Ritaglia tutte le pagine con un margine uniforme
Lo scenario più comune è applicare la stessa riduzione del margine a ogni pagina di un documento. Si itera su doc.Pages, si legge il MediaBox di ogni pagina e si imposta un CropBox rientrato di un numero fisso di punti su tutti e quattro i lati.
L'esempio seguente ritaglia 60 punti da ogni bordo di ogni pagina — quanto basta per rimuovere un ampio bordo bianco o una cornice indesiderata:
function App() {
  const cropPdfPage = async () => {
    // Get the Spire.PDF WASM module
    const pdfModule = window.wasmModule?.spirepdf;

    // Check whether the module is ready
    if (!pdfModule) {
      alert('Spire.PDF is not ready yet');
      return;
    }

    // Load the PDF file to be cropped into the VFS
    const inputFileName = 'ToCrop.pdf';
    await window.spire.FetchFileToVFS(inputFileName, "", `${process.env.PUBLIC_URL}/data/`);

    // Create a PdfDocument object and load the PDF document
    let doc = new pdfModule.PdfDocument();
    doc.LoadFromFile(inputFileName);

    // Trim 60 points off every side
    const margin = 60;

    for (let i = 0; i < doc.Pages.Count; i++) {
      const page = doc.Pages.get_Item(i);

      // MediaBox gives the full extent of the page, from which the crop box is derived
      // (x and y are measured from the top-left corner of the page)
      const width = page.MediaBox.Width;
      const height = page.MediaBox.Height;

      page.CropBox = new pdfModule.RectangleF({
        x: margin,
        y: margin,
        width: width - margin * 2,
        height: height - margin * 2,
      });
    }

    const outputFileName = 'CropByMargins.pdf';
    doc.SaveToFile(outputFileName);
    doc.Close();

    // Read the generated file from the VFS and trigger the download
    const fileArray = window.dotnetRuntime.Module.FS.readFile(outputFileName);
    const blob = new Blob([fileArray], { type: 'application/pdf' });
    const url = URL.createObjectURL(blob);
    const a = document.createElement('a');
    a.href = url;
    a.download = outputFileName;
    a.click();
    URL.revokeObjectURL(url);
  };

  return (
    <div style={{ textAlign: 'center', height: '300px' }}>
      <h1>Crop PDF Pages</h1>
      <button onClick={cropPdfPage}>
        Crop PDF
      </button>
    </div>
  );
}

export default App;
Entrambe le pagine vengono ritagliate con un margine di 60 punti, quindi il margine bianco e la cornice attorno alla pagina vengono rimossi:
Modifica il valore di margin per controllare quanto aggressivamente viene ritagliata la pagina. Un valore più grande rimuove più spazio bianco; un valore più piccolo esegue un ritaglio più sottile. Poiché il margine viene applicato uniformemente su tutti e quattro i lati, questo approccio funziona meglio quando il bordo indesiderato è più o meno uguale su ogni lato — cosa che di solito accade con documenti scansionati e disegni esportati.
Ritaglio di una singola pagina rispetto all'intero documento
Il ciclo nella sezione precedente applica lo stesso ritaglio a ogni pagina. Ma CropBox è una proprietà a livello di pagina — non esiste un'interfaccia di ritaglio a livello di documento. Il ciclo si limita a garantire che ogni pagina riceva lo stesso margine. Questa distinzione è importante quando le pagine hanno esigenze diverse.
Quando ritagliare l'intero documento: Usa l'approccio con ciclo quando tutte le pagine condividono lo stesso problema — ad esempio, un lotto scansionato in cui ogni pagina ha lo stesso bordo dello scanner, o un set di disegni multi-pagina esportato con margini identici. Un unico valore di margin mantiene il codice semplice e il risultato coerente.
Quando ritagliare una singola pagina: Elimina il ciclo e assegna il CropBox direttamente alla pagina di destinazione. È utile quando solo una pagina necessita di ritaglio — ad esempio, una copertina con un logo sovradimensionato, o una fattura in cui dovrebbe essere visibile solo l'area della tabella a pagina 2. Puoi anche applicare valori di ritaglio diversi a pagine diverse combinando la logica per pagina all'interno del ciclo.
Ecco come ritagliare solo la prima pagina, mantenendo un blocco di 400 × 500 punti a partire dalla posizione (80, 80) dall'angolo in alto a sinistra:
// Crop page 1 only: keep a 400 x 500 point block starting at (80, 80) from the top-left corner
const page = doc.Pages.get_Item(0);
page.CropBox = new pdfModule.RectangleF({ x: 80, y: 80, width: 400, height: 500 });
I valori x e y specificano dove inizia la regione visibile, misurata dall'angolo in alto a sinistra della pagina. I valori width e height definiscono la dimensione di tale regione. Tutto ciò che è al di fuori di questo rettangolo viene nascosto al visualizzatore.
Ritaglio soft: cosa succede al contenuto
C'è un dettaglio importante su CropBox che è facile trascurare: esegue un ritaglio soft, non uno hard.
Quando imposti il CropBox, stai modificando il confine visibile della pagina — il rettangolo che i visualizzatori PDF mostrano e che le stampanti usano come area della pagina. Ma il contenuto che cade al di fuori di questo confine non viene rimosso dal file. È ancora lì, solo nascosto. Questo ha due conseguenze pratiche:
La dimensione del file non diminuisce. Il testo, le immagini e la grafica vettoriale ritagliati via restano nel flusso di dati PDF. Se il tuo obiettivo è ridurre la dimensione del file tagliando i margini, impostare solo il CropBox non lo raggiungerà.
Il contenuto ritagliato è ancora ricercabile. Il testo al di fuori del CropBox visibile può ancora essere trovato dalle funzioni di ricerca e copiato dagli utenti che sanno come selezionare oltre l'area visibile. Di solito va bene per tagliare i margini, ma significa che il ritaglio non è un modo per oscurare o rimuovere in modo sicuro informazioni sensibili.
Se devi eliminare davvero il contenuto — per redazione, riduzione della dimensione del file, o per garantire che il testo nascosto non possa essere recuperato — devi ricostruire la pagina. L'approccio consiste nel creare un nuovo documento, estrarre il contenuto visibile dalla pagina ritagliata usando page.CreateTemplate(), disegnarlo su una pagina nuova nel nuovo documento e salvare il risultato. Questo produce un ritaglio hard in cui il contenuto fuori dai limiti non esiste più nel file.
Per la maggior parte dei casi d'uso di taglio dei margini e rimozione dello spazio bianco, tuttavia, il ritaglio soft con CropBox è esattamente ciò che desideri: è veloce, semplice e produce un risultato visivamente pulito senza il sovraccarico di ricostruire il documento.
FAQ
Posso ritagliare una singola pagina invece dell'intero documento?
Sì. Poiché CropBox è una proprietà per pagina, non esiste un metodo integrato per "ritagliare l'intero documento" — il ciclo nell'esempio principale è solo una comodità per applicare lo stesso margine a ogni pagina. Per ritagliare solo una pagina, salta il ciclo e assegna il CropBox direttamente a quella pagina:
// Crop page 1 only: keep a 400 x 500 point block starting at (80, 80) from the top-left corner
const page = doc.Pages.get_Item(0);
page.CropBox = new pdfModule.RectangleF({ x: 80, y: 80, width: 400, height: 500 });
Come annullo un ritaglio?
Impostare CropBox modifica la casella della pagina sul posto e il documento non memorizza la casella precedente. Potresti aspettarti che assegnare page.MediaBox di nuovo a page.CropBox ripristinasse la vista originale, ma questo non funziona come previsto — le coordinate vengono applicate rispetto all'origine dell'area visibile corrente, quindi cambiano solo le dimensioni mentre l'origine resta fissa. Dopo un ritaglio di 60 punti, riassegnare le dimensioni del MediaBox lascia comunque l'area visibile che inizia da (60, 60).
La soluzione più semplice è ricaricare il file originale se lo hai ancora. Se è disponibile solo il file ritagliato, puoi spostare l'origine di nuovo nell'angolo in alto a sinistra usando offset negativi e ripristinare le dimensioni complete della pagina:
// Undo when the crop offset was (offsetX, offsetY)
page.CropBox = new pdfModule.RectangleF({
  x: -offsetX,
  y: -offsetY,
  width: page.MediaBox.Width,
  height: page.MediaBox.Height,
});
Il file non è diventato più piccolo e il contenuto ritagliato è ancora ricercabile — perché?
Questo è il comportamento previsto. CropBox esegue un ritaglio soft: cambia solo il confine visibile della pagina, mentre il contenuto al di fuori di quel confine rimane nel file e può ancora essere trovato dalla ricerca di testo o dalle operazioni di copia. Se devi rimuovere fisicamente il contenuto dal PDF, impostare il CropBox non è sufficiente — dovresti ricostruire la pagina creando un nuovo documento, estraendo il contenuto visibile con page.CreateTemplate(), disegnandolo su una nuova pagina e salvando in un nuovo file.
Vedi anche
Rogner les pages PDF : recadrer les marges et les espaces blancs avec JavaScript
Les PDF contiennent souvent plus d'espace blanc que nécessaire — des documents numérisés aux bordures épaisses, des dessins techniques aux marges généreuses, ou des factures où seul le tableau central importe. Rogner la page est la solution naturelle, mais y parvenir dans un flux de travail basé sur le navigateur n'est pas simple. Les outils de bureau rompent l'expérience web, et l'envoi du fichier à un serveur backend soulève des préoccupations de confidentialité et de conformité.
C'est là qu'intervient Spire.PDF for JavaScript. Il s'exécute sur WebAssembly et fonctionne entièrement dans le navigateur, chargeant et enregistrant les PDF via un système de fichiers virtuel (VFS) sans aller-retour vers un serveur. Vous pouvez définir programmatiquement la zone visible de chaque page et laisser l'utilisateur télécharger le résultat rogné — le tout côté client. Pour l'installation et la configuration du projet, consultez Intégrer Spire.PDF for JavaScript dans un projet React. Les exemples ci-dessous supposent que Spire.PDF est installé et que le module WebAssembly est initialisé.
CropBox et MediaBox : deux boîtes de page expliquées
Chaque page PDF est définie par deux rectangles, et il est essentiel de comprendre leur différence avant de commencer à rogner.
MediaBox décrit les dimensions physiques de la page — la feuille de papier complète, pour ainsi dire. C'est la limite la plus externe et elle définit l'espace de coordonnées dans lequel tout le contenu est placé. Une page A4 standard possède un MediaBox d'environ 595 × 842 points.
CropBox définit ce que la visionneuse affiche réellement. C'est une sous-région du MediaBox, et tout contenu tombant en dehors du CropBox est masqué à l'affichage. Par défaut, le CropBox correspond au MediaBox, ce qui explique pourquoi vous voyez normalement la page entière. Lorsque vous réduisez le CropBox, vous dites en pratique au lecteur PDF : "Affiche uniquement cette portion de la page."
L'idée clé pour le rognage est que le CropBox est dérivé du MediaBox. Vous lisez les dimensions complètes de la page à partir de page.MediaBox.Width et page.MediaBox.Height, puis vous calculez un rectangle plus petit — réduit de la marge souhaitée de chaque côté — et vous l'affectez à page.CropBox. Les coordonnées x et y du CropBox sont mesurées depuis le coin supérieur gauche de la page, et width et height déterminent la portion de page conservée.
Rogner toutes les pages avec une marge uniforme
Le scénario le plus courant consiste à appliquer la même réduction de marge à chaque page d'un document. Vous parcourez doc.Pages, lisez le MediaBox de chaque page et définissez un CropBox réduit d'un nombre fixe de points sur les quatre côtés.
L'exemple ci-dessous retire 60 points de chaque bord de chaque page — suffisant pour supprimer une large bordure blanche ou un cadre indésirable :
function App() {
  const cropPdfPage = async () => {
    // Get the Spire.PDF WASM module
    const pdfModule = window.wasmModule?.spirepdf;

    // Check whether the module is ready
    if (!pdfModule) {
      alert('Spire.PDF is not ready yet');
      return;
    }

    // Load the PDF file to be cropped into the VFS
    const inputFileName = 'ToCrop.pdf';
    await window.spire.FetchFileToVFS(inputFileName, "", `${process.env.PUBLIC_URL}/data/`);

    // Create a PdfDocument object and load the PDF document
    let doc = new pdfModule.PdfDocument();
    doc.LoadFromFile(inputFileName);

    // Trim 60 points off every side
    const margin = 60;

    for (let i = 0; i < doc.Pages.Count; i++) {
      const page = doc.Pages.get_Item(i);

      // MediaBox gives the full extent of the page, from which the crop box is derived
      // (x and y are measured from the top-left corner of the page)
      const width = page.MediaBox.Width;
      const height = page.MediaBox.Height;

      page.CropBox = new pdfModule.RectangleF({
        x: margin,
        y: margin,
        width: width - margin * 2,
        height: height - margin * 2,
      });
    }

    const outputFileName = 'CropByMargins.pdf';
    doc.SaveToFile(outputFileName);
    doc.Close();

    // Read the generated file from the VFS and trigger the download
    const fileArray = window.dotnetRuntime.Module.FS.readFile(outputFileName);
    const blob = new Blob([fileArray], { type: 'application/pdf' });
    const url = URL.createObjectURL(blob);
    const a = document.createElement('a');
    a.href = url;
    a.download = outputFileName;
    a.click();
    URL.revokeObjectURL(url);
  };

  return (
    <div style={{ textAlign: 'center', height: '300px' }}>
      <h1>Crop PDF Pages</h1>
      <button onClick={cropPdfPage}>
        Crop PDF
      </button>
    </div>
  );
}

export default App;
Les deux pages sont rognées avec une marge de 60 points, de sorte que la marge blanche et le cadre autour de la page sont supprimés :
Ajustez la valeur margin pour contrôler l'intensité du rognage de la page. Une valeur plus grande supprime davantage d'espace blanc ; une valeur plus petite effectue un rognage plus subtil. Comme la marge est appliquée uniformément aux quatre côtés, cette approche fonctionne mieux lorsque la bordure indésirable est à peu près égale sur chaque bord — ce qui est généralement le cas pour les documents numérisés et les dessins exportés.
Rognage d'une seule page ou de tout le document
La boucle de la section précédente applique le même rognage à chaque page. Mais CropBox est une propriété de niveau page — il n'existe pas d'interface de rognage à l'échelle du document. La boucle garantit simplement que chaque page reçoit la même marge. Cette distinction importe lorsque vos pages ont des besoins différents.
Quand rogner tout le document : utilisez l'approche par boucle lorsque toutes les pages présentent le même problème — par exemple, un lot numérisé où chaque page a la même bordure de scanner, ou un ensemble de dessins de plusieurs pages exportés avec des marges identiques. Une seule valeur margin garde le code simple et le résultat cohérent.
Quand rogner une seule page : supprimez la boucle et affectez le CropBox directement à la page cible. Cela est utile lorsqu'une seule page a besoin d'être rognée — par exemple, une page de couverture avec un logo surdimensionné, ou une facture où seule la zone du tableau de la page 2 doit être visible. Vous pouvez également appliquer des valeurs de rognage différentes à différentes pages en combinant une logique par page à l'intérieur de la boucle.
Voici comment rogner uniquement la première page, en conservant un bloc de 400 × 500 points à partir de la position (80, 80) depuis le coin supérieur gauche :
// Crop page 1 only: keep a 400 x 500 point block starting at (80, 80) from the top-left corner
const page = doc.Pages.get_Item(0);
page.CropBox = new pdfModule.RectangleF({ x: 80, y: 80, width: 400, height: 500 });
Les valeurs x et y spécifient où commence la région visible, mesurée depuis le coin supérieur gauche de la page. Les valeurs width et height définissent la taille de cette région. Tout ce qui se trouve en dehors de ce rectangle est masqué pour la visionneuse.
Rognage doux : ce qui arrive au contenu
Un détail important concernant CropBox est facile à négliger : il effectue un rognage doux, et non un rognage définitif.
Lorsque vous définissez le CropBox, vous modifiez la limite visible de la page — le rectangle que les lecteurs PDF affichent et que les imprimantes utilisent comme zone de page. Mais le contenu qui tombe en dehors de cette limite n'est pas supprimé du fichier. Il est toujours là, simplement masqué. Cela a deux conséquences pratiques :
La taille du fichier ne diminue pas. Le texte, les images et les graphiques vectoriels rognés restent dans le flux de données du PDF. Si votre objectif est de réduire la taille du fichier en rognant les marges, définir le CropBox seul ne suffira pas.
Le contenu rogné reste recherchable. Le texte situé en dehors du CropBox visible peut toujours être trouvé par les fonctions de recherche et copié par les utilisateurs qui savent sélectionner au-delà de la zone visible. C'est généralement acceptable pour rogner les marges, mais cela signifie que le rognage n'est pas un moyen de caviarder ni de supprimer de manière sécurisée des informations sensibles.
Si vous devez véritablement éliminer du contenu — pour le caviardage, la réduction de la taille du fichier, ou pour garantir que le texte masqué ne puisse pas être récupéré — vous devez reconstruire la page. L'approche consiste à créer un nouveau document, à extraire le contenu visible de la page rognée à l'aide de page.CreateTemplate(), à le dessiner sur une nouvelle page du nouveau document, puis à enregistrer le résultat. Cela produit un rognage définitif où le contenu hors limites n'existe plus dans le fichier.
Pour la plupart des cas d'usage de rognage de marges et de suppression d'espaces blancs, toutefois, le rognage doux avec CropBox est exactement ce qu'il vous faut : il est rapide, simple et produit un résultat visuellement propre sans la surcharge liée à la reconstruction du document.
FAQ
Puis-je rogner une seule page au lieu de tout le document ?
Oui. Comme CropBox est une propriété par page, il n'existe pas de méthode intégrée pour "rogner tout le document" — la boucle de l'exemple principal n'est qu'une commodité pour appliquer la même marge à chaque page. Pour rogner une seule page, omettez la boucle et affectez le CropBox directement à cette page :
// Crop page 1 only: keep a 400 x 500 point block starting at (80, 80) from the top-left corner
const page = doc.Pages.get_Item(0);
page.CropBox = new pdfModule.RectangleF({ x: 80, y: 80, width: 400, height: 500 });
Comment annuler un rognage ?
Définir CropBox modifie la boîte de page sur place, et le document ne conserve pas la boîte précédente. Vous pourriez penser qu'affecter page.MediaBox à page.CropBox restaurerait la vue d'origine, mais cela ne fonctionne pas comme prévu — les coordonnées sont appliquées relativement à l'origine de la zone visible actuelle, de sorte que seules les dimensions changent tandis que l'origine reste fixe. Après un rognage de 60 points, réaffecter les dimensions du MediaBox laisse toujours la zone visible commencer à (60, 60).
La solution la plus simple consiste à recharger le fichier d'origine si vous l'avez encore. Si seul le fichier rogné est disponible, vous pouvez décaler l'origine vers le coin supérieur gauche à l'aide de décalages négatifs et restaurer les dimensions complètes de la page :
// Undo when the crop offset was (offsetX, offsetY)
page.CropBox = new pdfModule.RectangleF({
  x: -offsetX,
  y: -offsetY,
  width: page.MediaBox.Width,
  height: page.MediaBox.Height,
});
Le fichier n'a pas diminué et le contenu rogné est toujours recherchable — pourquoi ?
Il s'agit d'un comportement attendu. CropBox effectue un rognage doux : il ne modifie que la limite visible de la page, tandis que le contenu situé en dehors de cette limite reste dans le fichier et peut toujours être trouvé par recherche de texte ou par des opérations de copie. Si vous devez supprimer physiquement le contenu du PDF, définir le CropBox ne suffit pas — vous devriez reconstruire la page en créant un nouveau document, en extrayant le contenu visible avec page.CreateTemplate(), en le dessinant sur une nouvelle page et en enregistrant le tout dans un nouveau fichier.
Voir aussi
Recortar páginas PDF: elimina márgenes y espacios en blanco con JavaScript
Tabla de contenidos
Los PDF suelen contener más espacio en blanco del que necesitan: documentos escaneados con bordes gruesos, planos de ingeniería con márgenes generosos o facturas en las que solo importa la tabla central. Recortar la página es la solución natural, pero hacerlo en un flujo de trabajo basado en el navegador no es sencillo. Las herramientas de escritorio rompen la experiencia web, y enviar el archivo a un servidor backend plantea problemas de privacidad y cumplimiento.
Aquí es donde entra en juego Spire.PDF for JavaScript. Se ejecuta sobre WebAssembly y opera por completo dentro del navegador, cargando y guardando archivos PDF a través de un sistema de archivos virtual (VFS) sin necesidad de idas y vueltas al servidor. Puede establecer el área visible de cada página mediante programación y permitir que el usuario descargue el resultado recortado, todo del lado del cliente. Para la instalación y la configuración del proyecto, consulte Integrar Spire.PDF for JavaScript en un proyecto de React. Los ejemplos siguientes suponen que Spire.PDF está instalado y que el módulo WebAssembly está inicializado.
CropBox y MediaBox: dos cuadros de página explicados
Cada página de PDF se define mediante dos rectángulos, y comprender la diferencia entre ellos es esencial antes de empezar a recortar.
MediaBox describe las dimensiones físicas de la página, es decir, la hoja de papel completa. Es el límite más externo y define el espacio de coordenadas en el que se coloca todo el contenido. Una página A4 estándar tiene un MediaBox de aproximadamente 595 × 842 puntos.
CropBox define lo que realmente muestra el visor. Es una subregión del MediaBox, y cualquier contenido que quede fuera del CropBox se oculta a la vista. De forma predeterminada, el CropBox coincide con el MediaBox, por lo que normalmente se ve la página completa. Cuando reduce el CropBox, en efecto le está diciendo al lector de PDF: "Muestre solo esta parte de la página."
La clave para el recorte es que el CropBox se deriva del MediaBox. Se leen las dimensiones completas de la página desde page.MediaBox.Width y page.MediaBox.Height, luego se calcula un rectángulo más pequeño, con un margen interior del valor que se desee en cada lado, y se asigna a page.CropBox. Las coordenadas x e y del CropBox se miden desde la esquina superior izquierda de la página, y width y height determinan cuánto de la página se conserva.
Recortar todas las páginas con un margen uniforme
El escenario más común es aplicar la misma reducción de margen a todas las páginas de un documento. Se itera sobre doc.Pages, se lee el MediaBox de cada página y se establece un CropBox con un margen interior de un número fijo de puntos en los cuatro lados.
El ejemplo siguiente recorta 60 puntos de cada borde de cada página, suficiente para eliminar un borde blanco ancho o un marco no deseado:
function App() {
  const cropPdfPage = async () => {
    // Get the Spire.PDF WASM module
    const pdfModule = window.wasmModule?.spirepdf;

    // Check whether the module is ready
    if (!pdfModule) {
      alert('Spire.PDF is not ready yet');
      return;
    }

    // Load the PDF file to be cropped into the VFS
    const inputFileName = 'ToCrop.pdf';
    await window.spire.FetchFileToVFS(inputFileName, "", `${process.env.PUBLIC_URL}/data/`);

    // Create a PdfDocument object and load the PDF document
    let doc = new pdfModule.PdfDocument();
    doc.LoadFromFile(inputFileName);

    // Trim 60 points off every side
    const margin = 60;

    for (let i = 0; i < doc.Pages.Count; i++) {
      const page = doc.Pages.get_Item(i);

      // MediaBox gives the full extent of the page, from which the crop box is derived
      // (x and y are measured from the top-left corner of the page)
      const width = page.MediaBox.Width;
      const height = page.MediaBox.Height;

      page.CropBox = new pdfModule.RectangleF({
        x: margin,
        y: margin,
        width: width - margin * 2,
        height: height - margin * 2,
      });
    }

    const outputFileName = 'CropByMargins.pdf';
    doc.SaveToFile(outputFileName);
    doc.Close();

    // Read the generated file from the VFS and trigger the download
    const fileArray = window.dotnetRuntime.Module.FS.readFile(outputFileName);
    const blob = new Blob([fileArray], { type: 'application/pdf' });
    const url = URL.createObjectURL(blob);
    const a = document.createElement('a');
    a.href = url;
    a.download = outputFileName;
    a.click();
    URL.revokeObjectURL(url);
  };

  return (
    <div style={{ textAlign: 'center', height: '300px' }}>
      <h1>Crop PDF Pages</h1>
      <button onClick={cropPdfPage}>
        Crop PDF
      </button>
    </div>
  );
}

export default App;
Ambas páginas se recortan con un margen de 60 puntos, por lo que se eliminan el margen blanco y el marco que rodea la página:
Ajuste el valor de margin para controlar con qué agresividad se recorta la página. Un valor mayor elimina más espacio en blanco; un valor menor realiza un recorte más sutil. Como el margen se aplica de forma uniforme a los cuatro lados, este enfoque funciona mejor cuando el borde no deseado es aproximadamente igual en todos los lados, que es lo habitual en documentos escaneados y planos exportados.
Recortar una sola página o todo el documento
El bucle de la sección anterior aplica el mismo recorte a todas las páginas. Pero CropBox es una propiedad de nivel de página: no existe una interfaz de recorte para todo el documento. El bucle simplemente garantiza que cada página reciba el mismo margen. Esta distinción es importante cuando sus páginas tienen necesidades diferentes.
Cuándo recortar todo el documento: utilice el enfoque con bucle cuando todas las páginas compartan el mismo problema, por ejemplo, un lote escaneado en el que cada página tiene el mismo borde del escáner, o un conjunto de planos de varias páginas exportado con márgenes idénticos. Un único valor de margin mantiene el código sencillo y el resultado coherente.
Cuándo recortar una sola página: elimine el bucle y asigne el CropBox directamente a la página de destino. Esto resulta útil cuando solo una página necesita recorte, por ejemplo, una portada con un logotipo de gran tamaño o una factura en la que solo debe verse la región de la tabla de la página 2. También puede aplicar valores de recorte distintos a páginas distintas combinando lógica por página dentro del bucle.
A continuación se muestra cómo recortar solo la primera página, conservando un bloque de 400 × 500 puntos que comienza en la posición (80, 80) desde la esquina superior izquierda:
// Crop page 1 only: keep a 400 x 500 point block starting at (80, 80) from the top-left corner
const page = doc.Pages.get_Item(0);
page.CropBox = new pdfModule.RectangleF({ x: 80, y: 80, width: 400, height: 500 });
Los valores x e y especifican dónde comienza la región visible, medidos desde la esquina superior izquierda de la página. Los valores width y height definen el tamaño de esa región. Todo lo que quede fuera de este rectángulo se oculta al visor.
Recorte suave: qué ocurre con el contenido
Hay un detalle importante sobre CropBox que es fácil pasar por alto: realiza un recorte suave, no uno duro.
Cuando establece el CropBox, cambia el límite visible de la página: el rectángulo que muestran los visores de PDF y que las impresoras utilizan como área de página. Pero el contenido que queda fuera de este límite no se elimina del archivo. Sigue estando ahí, solo que oculto. Esto tiene dos consecuencias prácticas:
El tamaño del archivo no disminuye. El texto, las imágenes y los gráficos vectoriales recortados permanecen en el flujo de datos del PDF. Si su objetivo es reducir el tamaño del archivo recortando márgenes, establecer solo el CropBox no lo conseguirá.
El contenido recortado sigue siendo buscable. El texto que está fuera del CropBox visible todavía puede encontrarse con las funciones de búsqueda y copiarse por usuarios que sepan cómo seleccionar más allá del área visible. Por lo general, esto no supone un problema al recortar márgenes, pero significa que el recorte no es una forma de censurar ni de eliminar de manera segura información confidencial.
Si necesita eliminar realmente el contenido —para censurarlo, reducir el tamaño del archivo o asegurarse de que el texto oculto no pueda recuperarse—, debe reconstruir la página. El enfoque consiste en crear un documento nuevo, extraer el contenido visible de la página recortada con page.CreateTemplate(), dibujarlo en una página nueva del nuevo documento y guardar el resultado. Esto produce un recorte duro en el que el contenido fuera de los límites ya no existe en el archivo.
No obstante, para la mayoría de los casos de uso de recorte de márgenes y eliminación de espacio en blanco, el recorte suave con CropBox es exactamente lo que se necesita: es rápido, sencillo y produce un resultado visualmente limpio sin la sobrecarga de reconstruir el documento.
Preguntas frecuentes
¿Puedo recortar una sola página en lugar de todo el documento?
Sí. Como CropBox es una propiedad por página, no hay un método integrado para "recortar todo el documento": el bucle del ejemplo principal es solo una comodidad para aplicar el mismo margen a todas las páginas. Para recortar solo una página, omita el bucle y asigne el CropBox directamente a esa página:
// Crop page 1 only: keep a 400 x 500 point block starting at (80, 80) from the top-left corner
const page = doc.Pages.get_Item(0);
page.CropBox = new pdfModule.RectangleF({ x: 80, y: 80, width: 400, height: 500 });
¿Cómo deshago un recorte?
Establecer CropBox modifica el cuadro de página en el lugar, y el documento no almacena el cuadro anterior. Podría esperar que asignar page.MediaBox de nuevo a page.CropBox restaurara la vista original, pero esto no funciona como se pretende: las coordenadas se aplican en relación con el origen del área visible actual, por lo que solo cambian las dimensiones mientras el origen permanece fijo. Después de un recorte de 60 puntos, reasignar las dimensiones del MediaBox sigue dejando el área visible comenzando en (60, 60).
La solución más sencilla es volver a cargar el archivo original si todavía lo tiene. Si solo dispone del archivo recortado, puede desplazar el origen de nuevo a la esquina superior izquierda usando desplazamientos negativos y restaurar las dimensiones completas de la página:
// Undo when the crop offset was (offsetX, offsetY)
page.CropBox = new pdfModule.RectangleF({
  x: -offsetX,
  y: -offsetY,
  width: page.MediaBox.Width,
  height: page.MediaBox.Height,
});
El archivo no se redujo y el contenido recortado sigue siendo buscable, ¿por qué?
Este es el comportamiento esperado. CropBox realiza un recorte suave: solo cambia el límite visible de la página, mientras que el contenido fuera de ese límite permanece en el archivo y todavía puede encontrarse mediante búsquedas de texto u operaciones de copia. Si necesita eliminar físicamente el contenido del PDF, establecer el CropBox no es suficiente: tendría que reconstruir la página creando un documento nuevo, extrayendo el contenido visible con page.CreateTemplate(), dibujándolo en una página nueva y guardando en un archivo nuevo.